Agentic LLM Reasoning(一):从 Chain of Thought 到搜索、反思与 RLVR
文章目录
模型能回答一个问题,不等于它能完成一项任务。
普通 Chatbot 接收 Prompt,然后返回 Response;Agent 则要在不断变化的环境中决定下一步做什么,执行动作,读取结果,再判断应该继续、回退还是换一条路。这种能力首先依赖 Reasoning(推理)。
一个完整的 Agent 系统至少需要三类能力:
- Reasoning:分析状态、拆解问题、比较候选路径并形成决策;
- Action:调用工具,把决策转化为对外部世界的操作;
- Interaction:读取行动结果,与环境或其他 Agent 持续交换信息并修正策略。
本文是 Agentic Large Language Models 系列的第一篇。我不会把 Reasoning 当成一串孤立术语来罗列,而会沿着同一个问题展开:当一次生成或一条推理链不够可靠时,系统还能增加什么? 后续两篇将分别讨论 Action 和 Interaction。
系列导航:(一)Reasoning · (二)Action(待续) · (三)Interaction(待续)
1. 先定义边界:什么是 Agentic LLM?
可以把 Agentic LLM 定义为:
从环境接收自然语言或多模态输入,通过推理做出决策,并自主采取行动影响环境,以完成特定目标的智能体。
普通 Chatbot 的典型过程是:
|
|
Agentic LLM 的过程则是一个循环:
|
|
因此,Agent 的能力不只取决于 Base Model。它还取决于推理策略、工具、外部记忆、状态管理、环境反馈以及包裹模型的 Harness。
1.1 从训练模型到使用模型
一个现代 LLM 通常经历以下阶段:
| 阶段 | 目标 |
|---|---|
| 获取通用语料 | 建立大规模无标签训练集 |
| Pretraining | 通过自监督目标学习语言、知识和模式 |
| Supervised Fine-Tuning | 使用标注的指令—答案数据适配任务 |
| Instruction Tuning | 提升遵循自然语言指令的能力 |
| Preference Alignment | 通过 RLHF、DPO、RLVR 等方法对齐偏好或可验证目标 |
| 训练与部署优化 | 使用 LoRA、混合精度、蒸馏等降低成本 |
| Inference | 通过 Prompt、Context、Tools 和解码策略解决具体问题 |
前六步主要改变模型参数;Agentic Reasoning 大量发生在最后一步——不一定更新权重,而是在推理时给模型更多中间计算、候选路径、反馈和外部系统。
这是理解全文的关键:Reasoning 不只是模型“内部会不会想”,也包括外部算法如何组织多次模型调用、保存状态并使用验证结果。
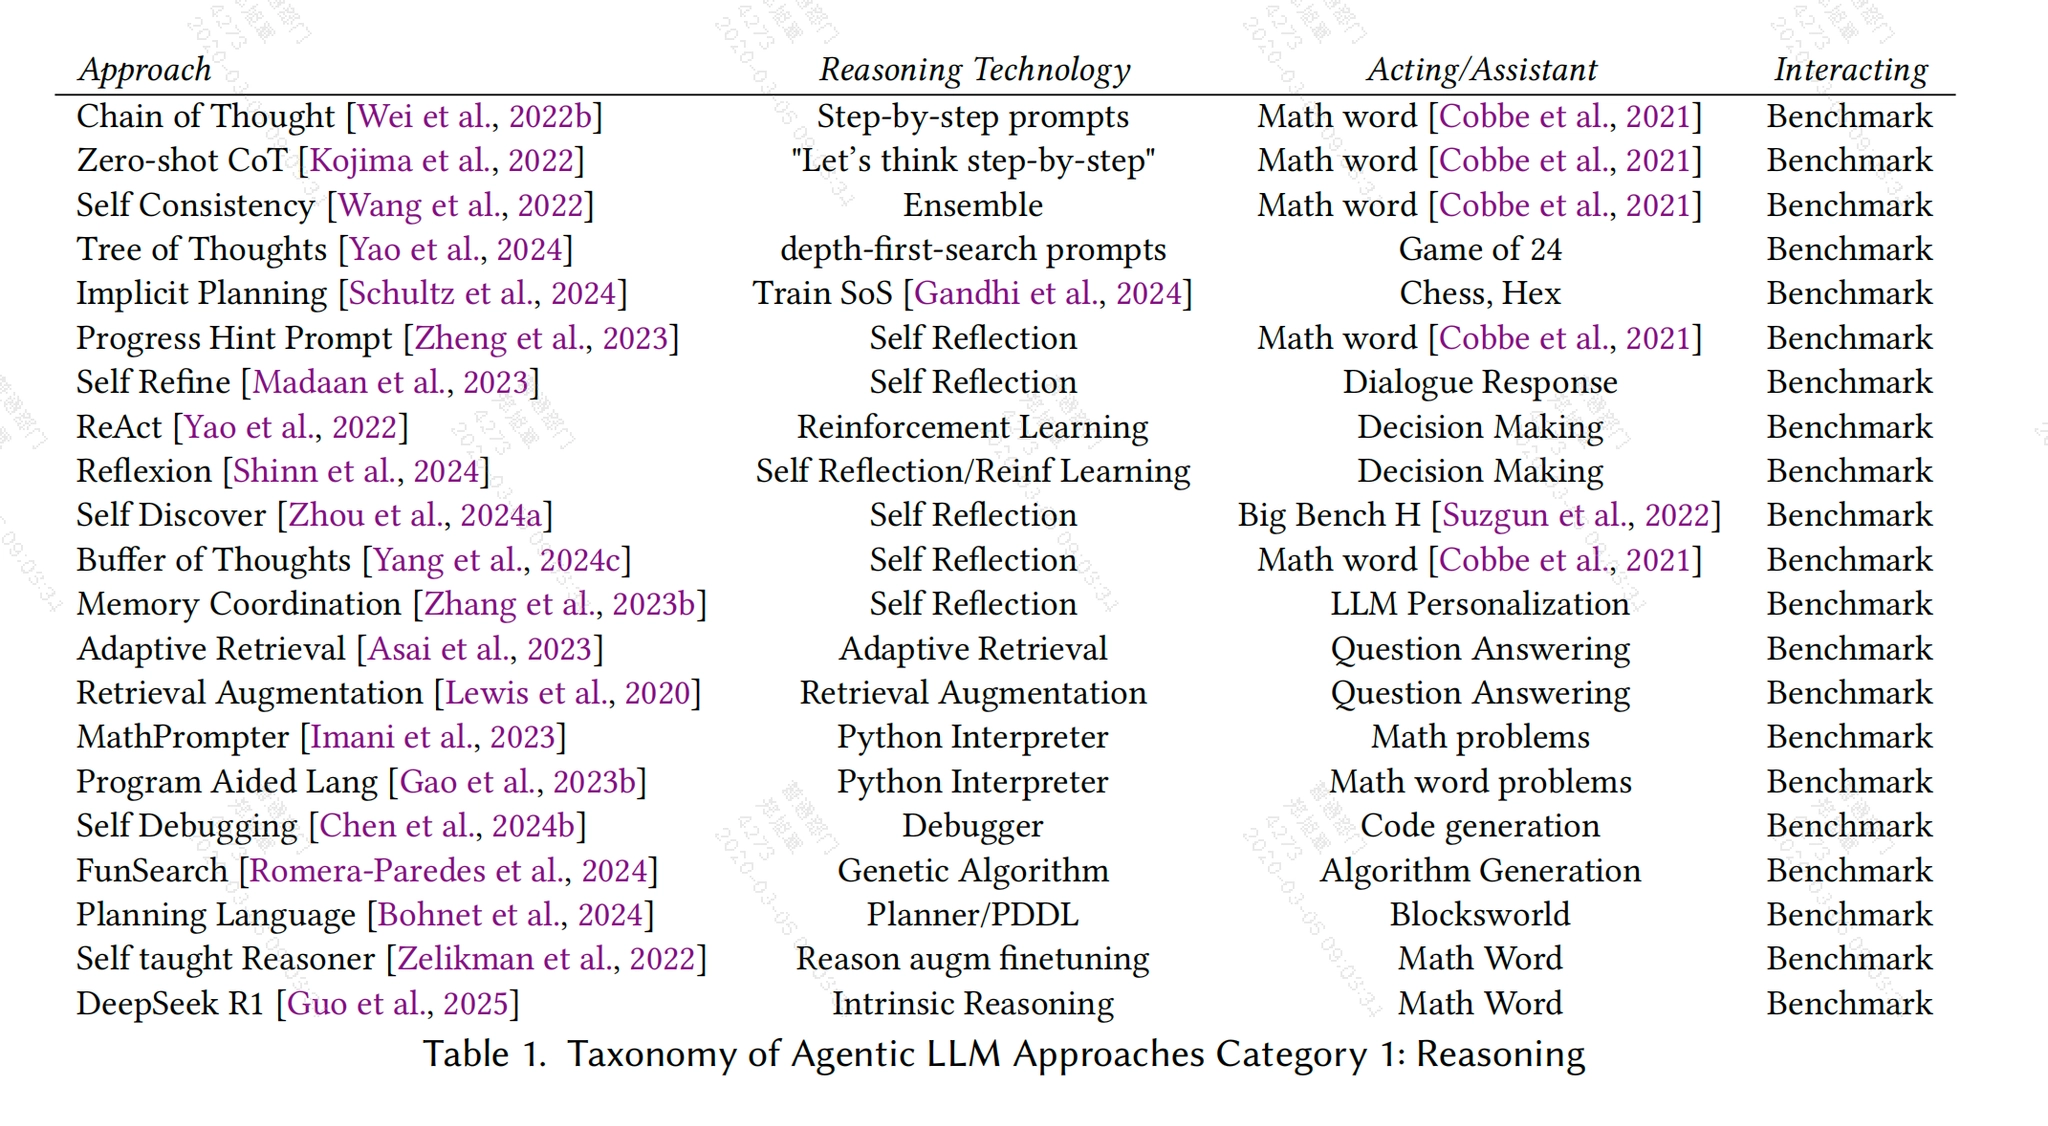
上图把 Reasoning 方法分为逐步提示、集成、搜索、自我反思、检索增强与强化学习。后文会沿着这条路线逐层展开。
2. 为什么模型“知道”,却不一定“做得出”?
以 GSM8K 中常见的数学文字题为例:
Romeo 一周烤 4 盘 Cookie,每盘包含 2 打。如果平均分给 16 个人,每人得到多少?
人类会把问题写成:
|
|
但早期 GPT-3 175B 在 GSM8K 上只有约 15% 的准确率。模型可能知道乘除法,也理解每个词,却无法稳定组织多步计算。
问题在于,自回归模型每次只预测下一个 Token。直接回答时,模型需要在一次连续生成中隐式完成:
- 找到相关事实;
- 识别变量和约束;
- 决定步骤顺序;
- 执行每一步计算;
- 避免早期错误向后传播。
问题并不一定是模型完全不会算,而是它要在一次连续生成中同时找事实、列约束、决定步骤、执行计算,还要避免早期错误继续传播。Reasoning 方法的作用,就是把这些隐式过程变成更长、更可观察、也更容易验证的计算路径。
从概率角度看,直接生成仍然是自回归分解:
这些方法没有改变自回归生成的基本形式。它们改变的是模型下一步生成时能够看到的条件:中间步骤、候选路径、验证结果和环境观察,都可以成为新的上下文。
3. 先给示例,再问新问题:In-Context Learning
In-Context Learning(ICL)把示例和问题一起放进 Context Window。模型不更新参数,只通过当前 Prompt 推断任务模式。
Zero-shot
只给指令与问题:
|
|
Few-shot
先提供少量相似例子:
|
|
Few-shot 示例的作用不只是展示输出格式,还会把模型引向更合适的知识与解题模式。但普通 ICL 仍然常把“过程”压缩在一次前向生成里。下一步自然是:把中间步骤也作为输出的一部分。
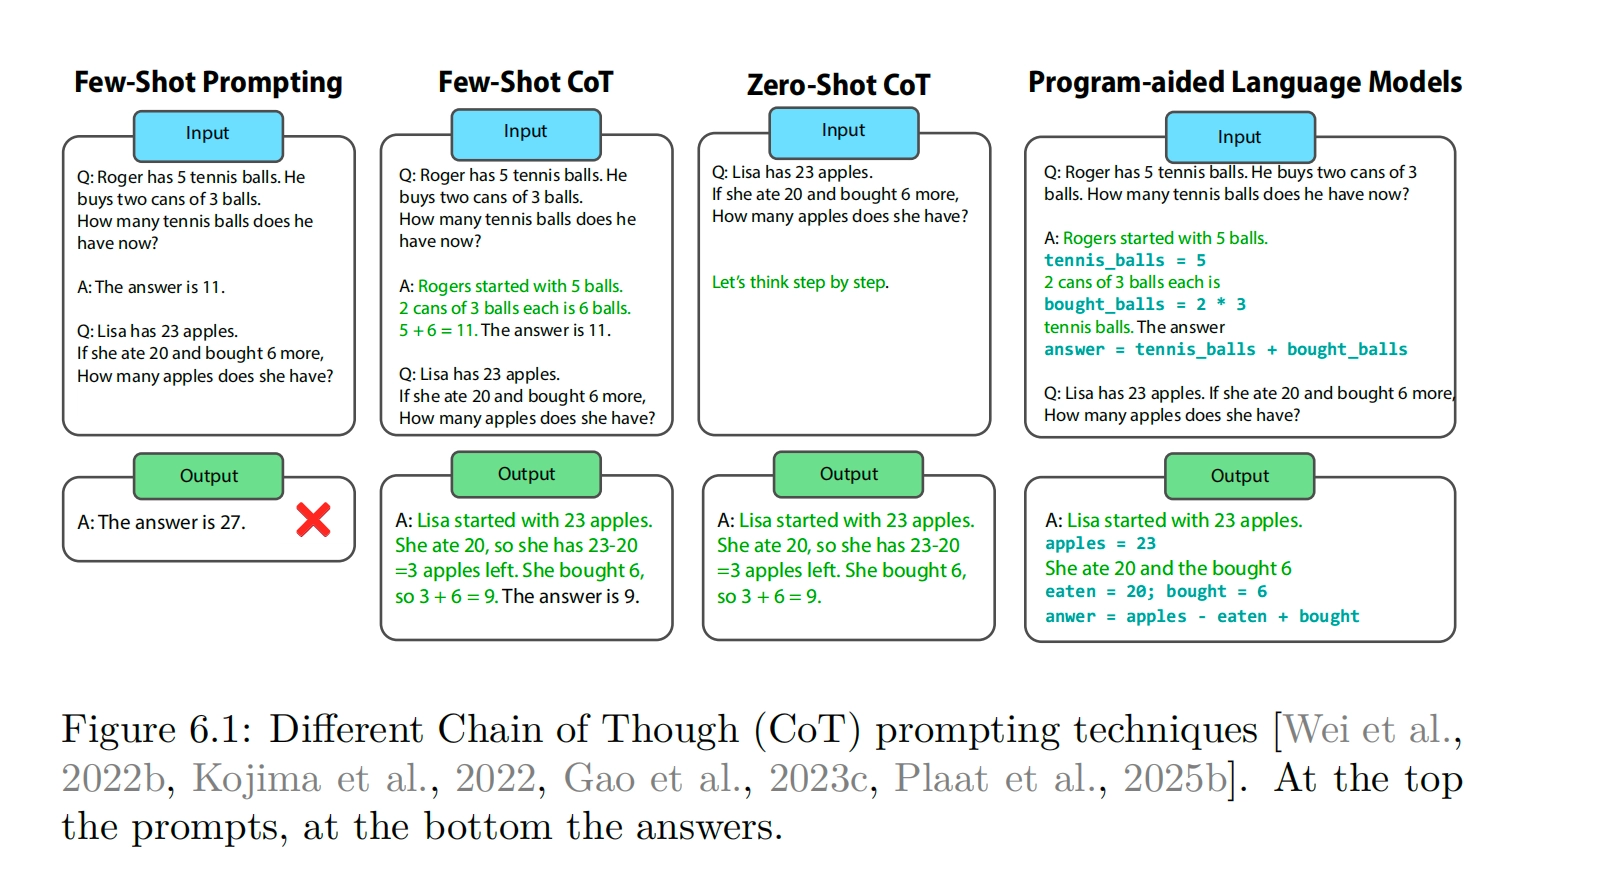
同一个问题可以通过普通 Few-shot、Few-shot CoT、Zero-shot CoT 或 PAL 进入完全不同的计算路径。
4. 把“过程”写出来:Chain of Thought
Chain-of-Thought Prompting 的核心非常简单:不要只要求最终答案,而是让模型生成一系列中间推理步骤。
|
|
在 Few-shot CoT 中,Prompt 给出带推理过程的示例;在 Zero-shot CoT 中,一句类似 “Let’s think step by step” 的指令也可能明显改善表现。原始 CoT 工作中,GSM8K 的示例结果从约 16% 提升到约 47%。
一种直观解释是:每个中间 Token 都会重新进入后续预测的上下文。模型因此获得了更多串行计算步骤,能够逐渐缩小最终答案的概率空间。
但 CoT 也引入了新问题:链条越长,错误累积的机会越多。如果第一步选错假设,后续步骤可能非常连贯地把错误推到结论。
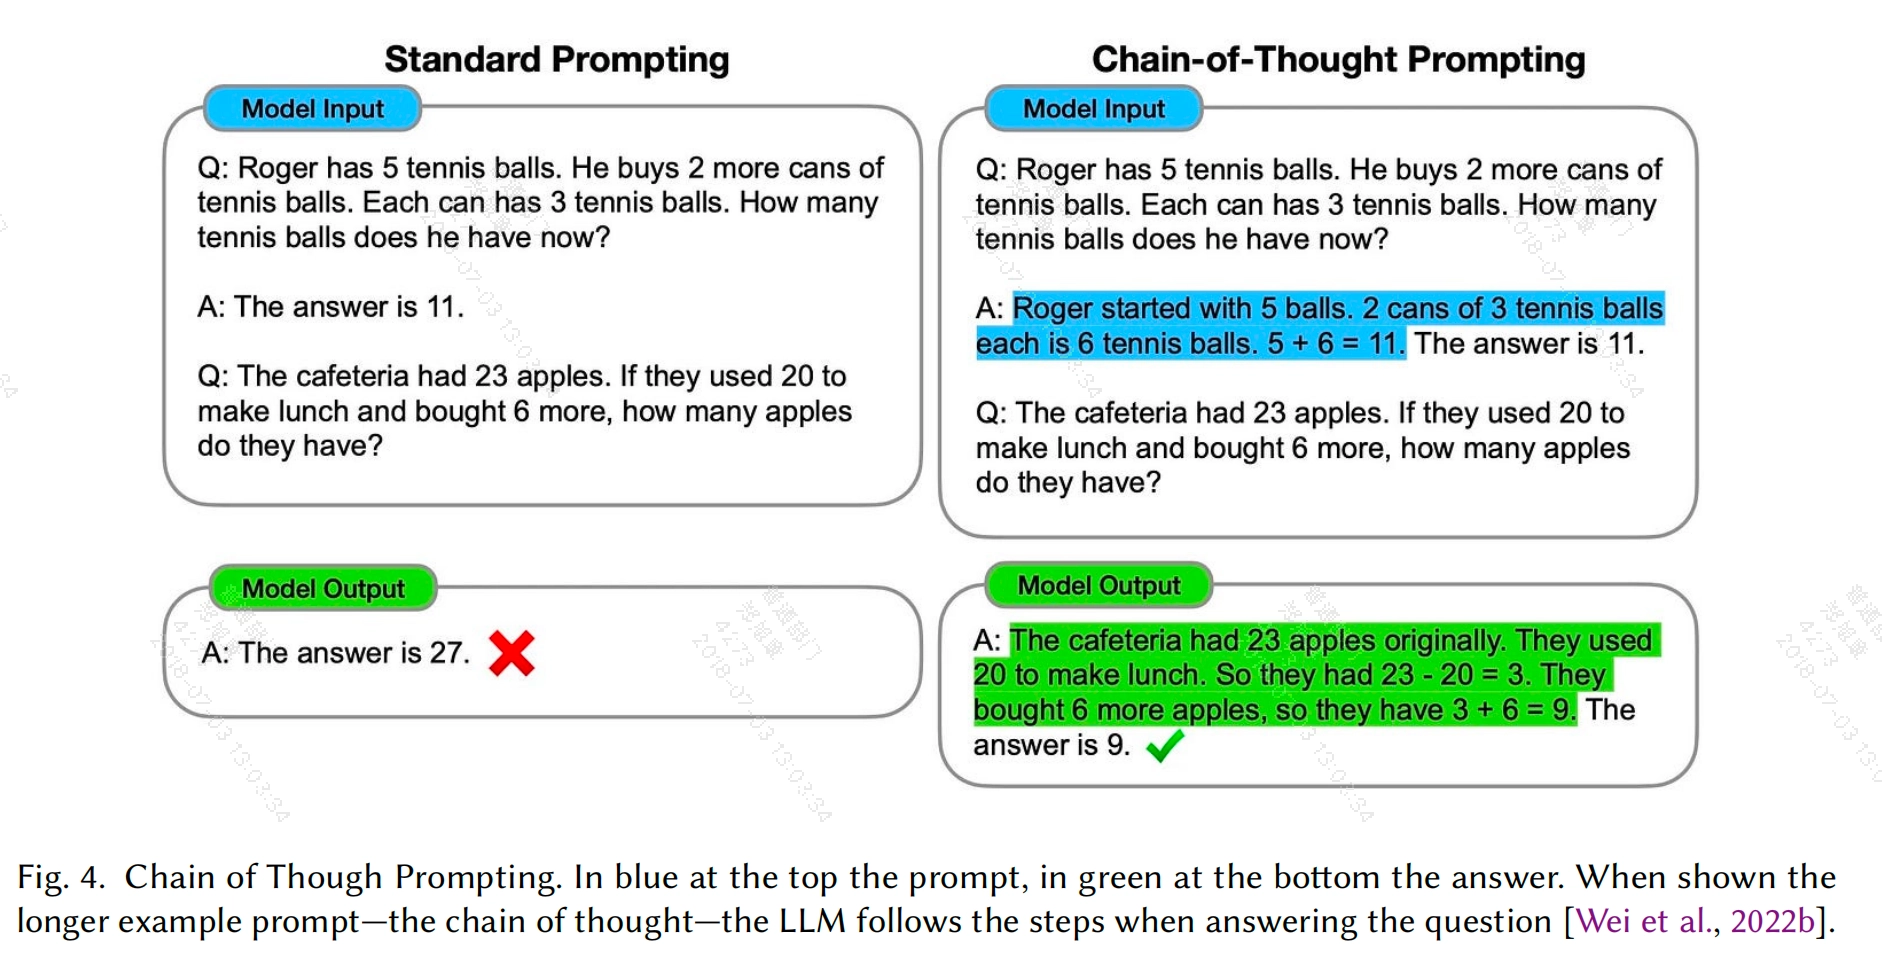
普通 Prompt 容易直接猜答案;CoT 示例则要求模型先展开计算,再给出结论。
5. 不要相信第一条推理链:验证与多路径投票
5.1 Self-Verification
Self-Verification 不直接相信第一次得到的结论,而是把结论作为条件,反向检查它是否与原问题一致。
|
|
这里,同一个 LLM 可以扮演生成者和验证者,也可以使用独立模型评价。关键不是“模型再想一次”,而是改变验证问题的形式,让错误暴露在新的约束下。
5.2 Self-Consistency
Self-Consistency 不只生成一条 CoT,而是采样多条不同的推理路径,再用最终答案的一致性进行聚合:
|
|
复杂问题往往存在多条通向正确答案的路径,而错误路径更容易彼此分散。因此,多数投票可以降低某一次采样走偏的影响。
原论文报告 Self-Consistency 在 GSM8K 上相对 CoT 提升 17.9 个百分点,在多个算术与常识推理基准上也有明显收益。代价是推理成本:采样 20 条路径通常意味着远高于单次生成的 Token 与延迟。
如果第 $i$ 条推理轨迹为 $r_i$,从轨迹抽取出的最终答案为 $a(r_i)$,多数投票可以写成:
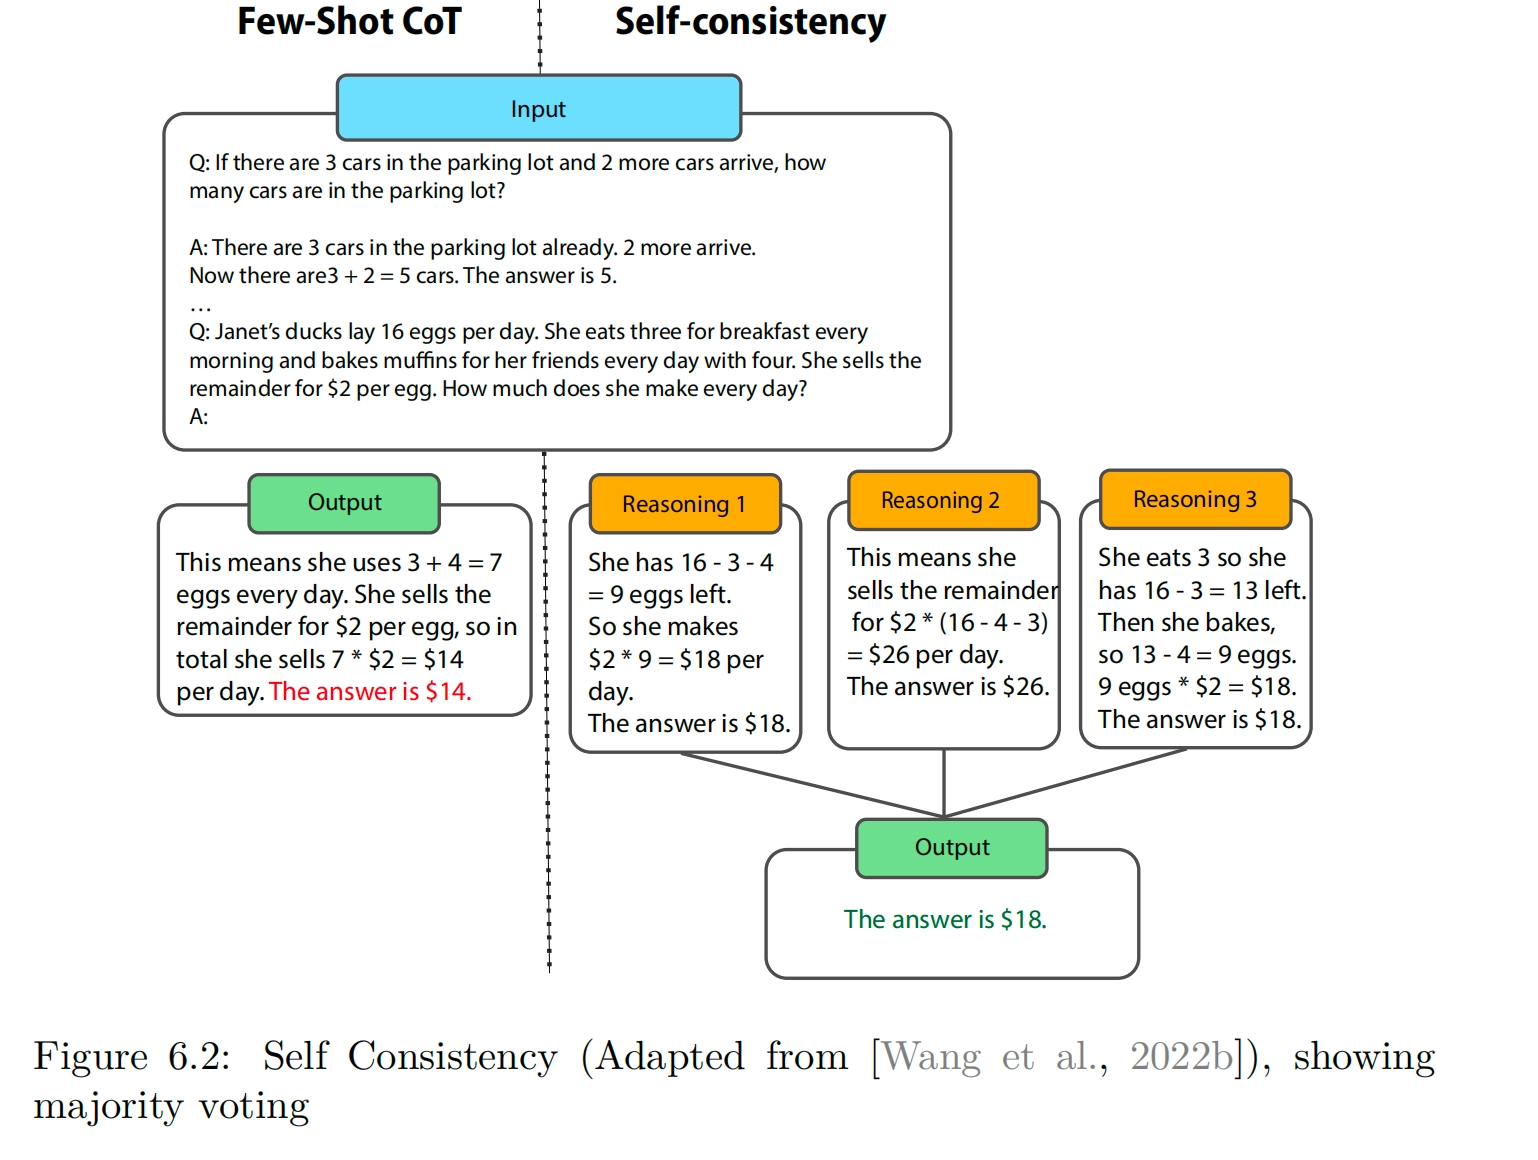
正确路径往往在最终答案上收敛,错误路径更容易彼此分散。Self-Consistency 利用的正是这个差异。
这说明推理能力不仅是模型参数的属性,也可以通过 inference-time compute 换取。
6. 让程序负责精确执行:PAL、Interpreter 与 Debugger
自然语言灵活,但存在歧义,并且不擅长可靠执行精确计算。一个实用策略是:让 LLM 负责理解与分解,让解释器负责执行。
6.1 Program-Aided Language Models
PAL 让模型把问题翻译为 Python 等可执行程序,再把求值交给解释器:
|
|
模型擅长把问题拆成程序结构;Python 擅长精确维护变量、循环与状态。PAL 使用 Codex 在 GSM8K 上报告了约 72% 的准确率,并在多类符号任务上超过了仅使用自然语言 CoT 的更大模型。
PAL 的分工可以简化为:模型生成程序 $g_{\theta}(x)$,执行器负责产生最终答案。
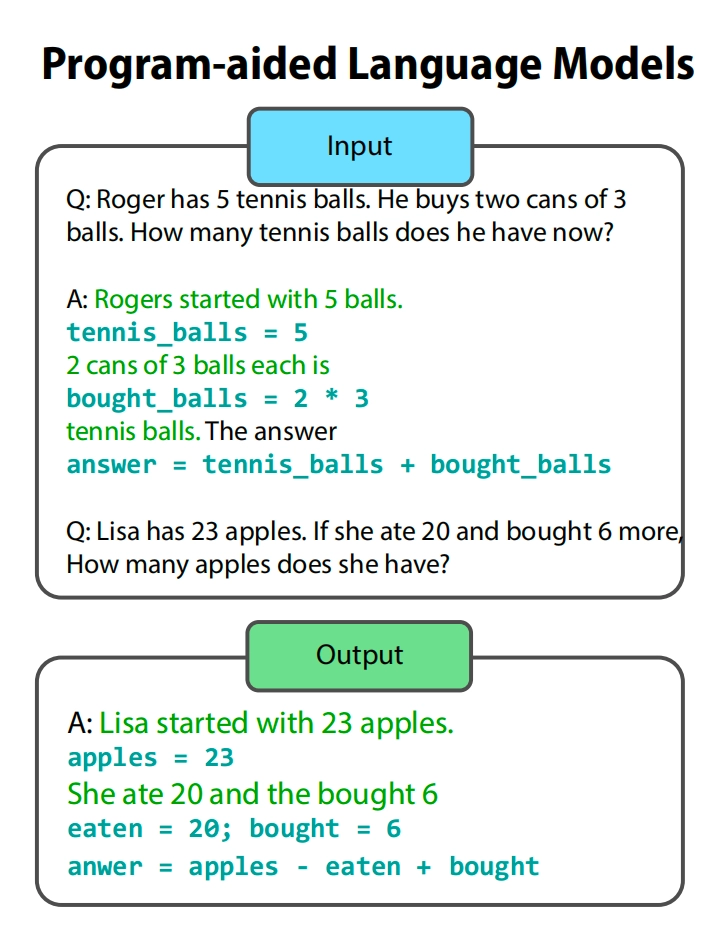
LLM 负责把自然语言问题翻译成程序;解释器负责可靠执行。
6.2 Interpreter、Debugger 与 Self-Debugging
生成代码后,系统还可以执行代码,把报错、测试失败或运行结果反馈给模型:
|
|
Self-Debugging 说明 LLM 可以通过检查执行结果和解释自己的代码定位错误。这里的 Ground Truth 不来自“模型觉得自己对了”,而来自编译器、解释器和测试。
这种组合也缓解了 Knowing–Doing Gap:模型可能能够用文字描述正确算法,却无法在 Token 序列中可靠维护每一次状态变化。让传统程序执行算法,往往比让 LLM 模拟执行更准确、更便宜。
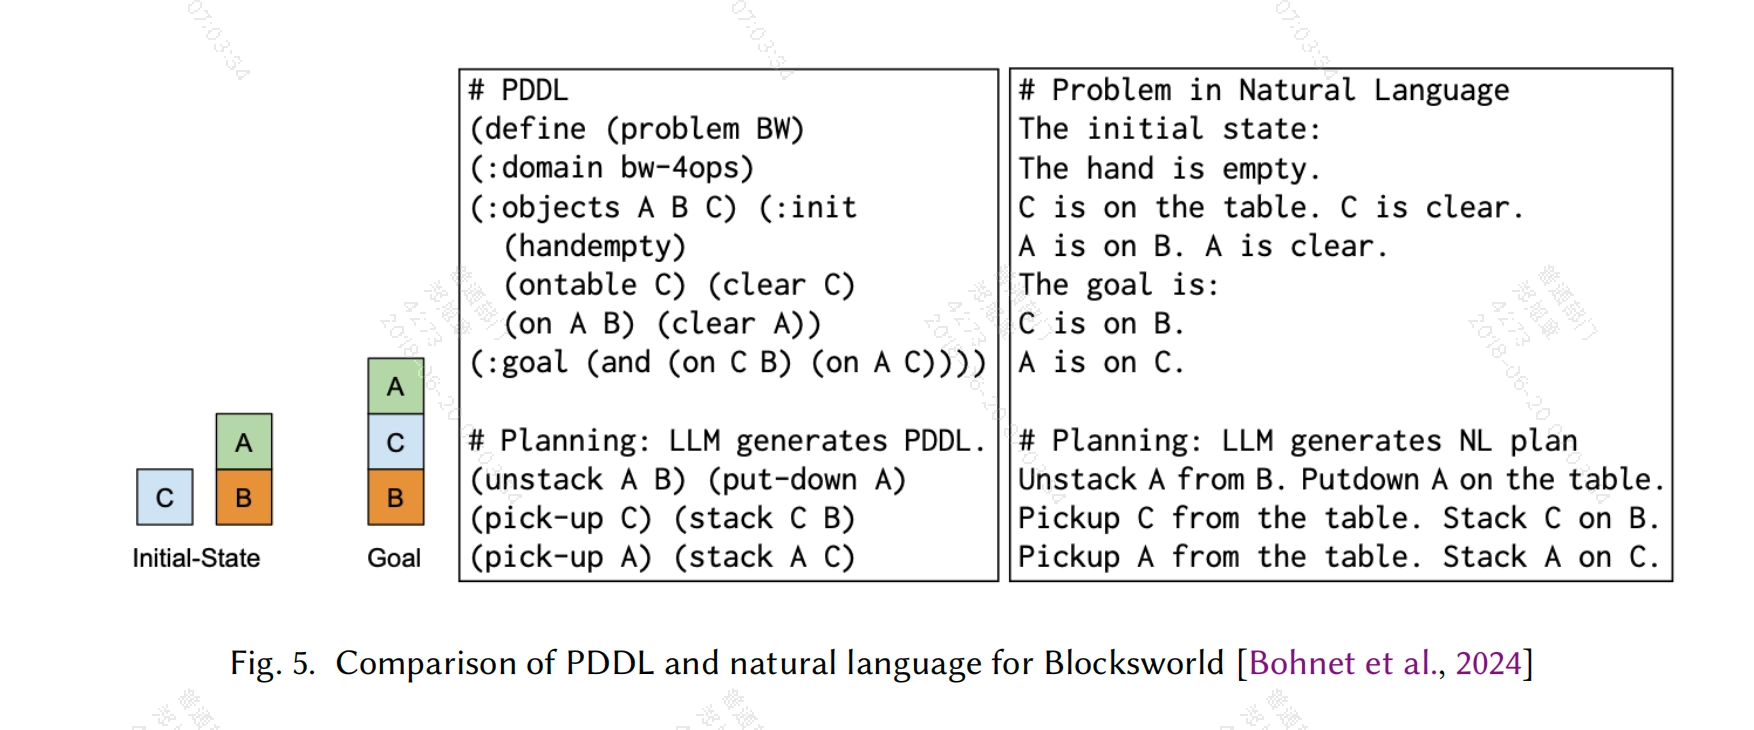
自然语言更容易阅读,PDDL 等形式语言则更适合严格表达状态、动作与约束。
7. 从一条链走向可回退的搜索树
CoT 本质上是一条单路径:每个 Thought 只有一个后继。Search-based 方法则在每一步生成多个候选,形成一个可以回溯的状态空间。
7.1 Tree of Thoughts
Tree of Thoughts(ToT) 把语言模型的中间推理视为搜索节点:
|
|
系统通常包含三个操作:
- Generate:为当前状态生成若干候选 Thought;
- Evaluate:评价候选是否有希望;
- Search:根据 BFS、DFS 或其他策略保留并扩展节点。
BFS 可以表示为:
|
|
DFS 则沿一个分支深入,在失败或达到边界后回溯。
如果 $s_t$ 表示第 $t$ 步的搜索状态,$z_t$ 表示候选 Thought,ToT 可以概括为“生成后评分,再保留最有希望的 $b$ 个状态”:
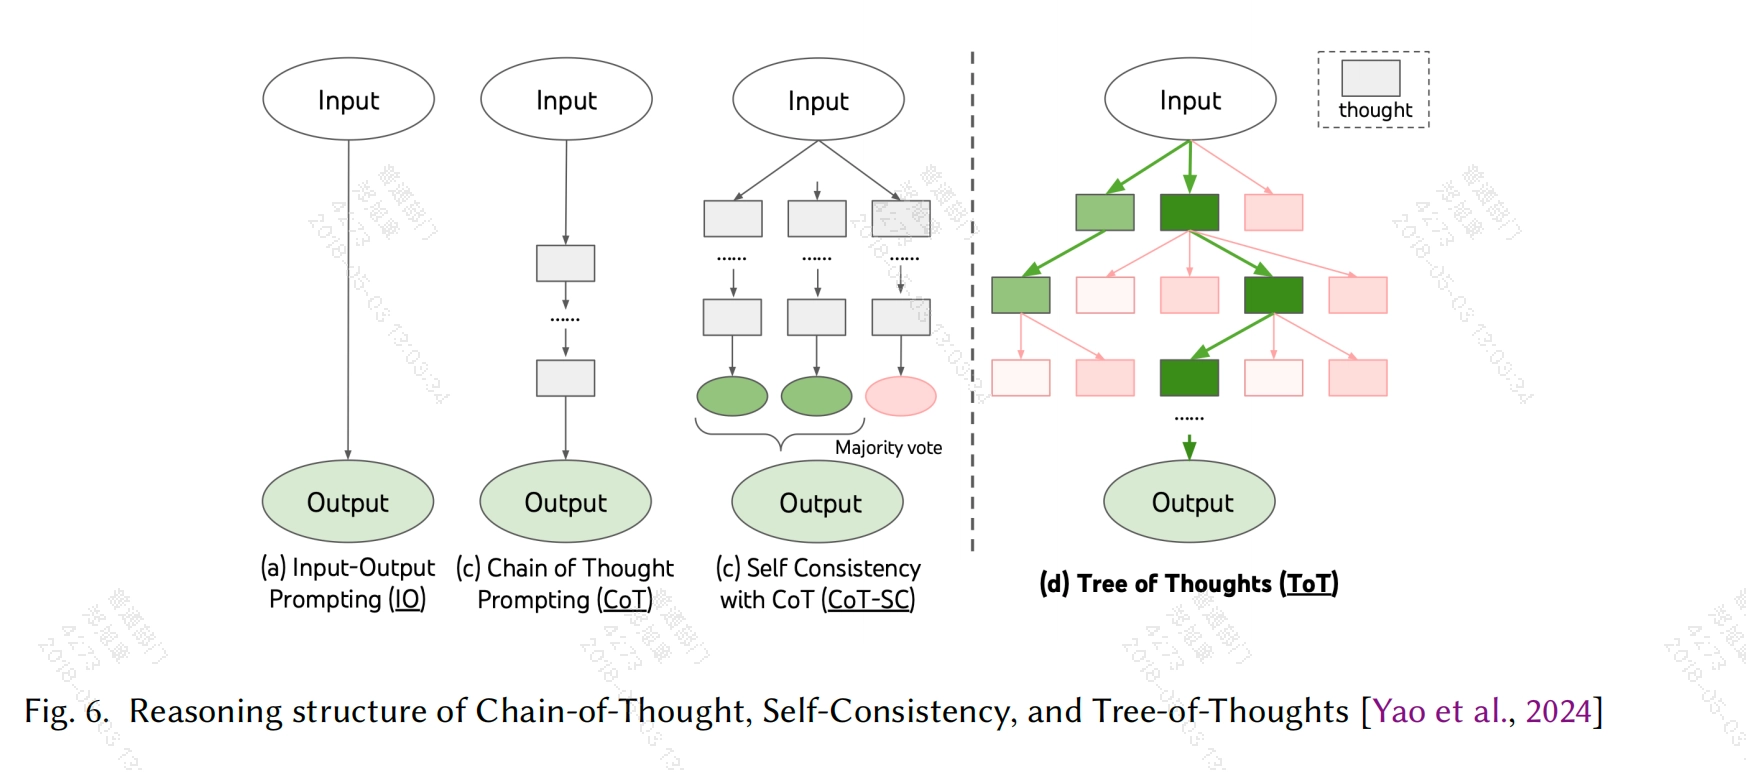
CoT 只展开一条链;Self-Consistency 独立采样多条链;ToT 会在中间状态处分支、评分和剪枝。
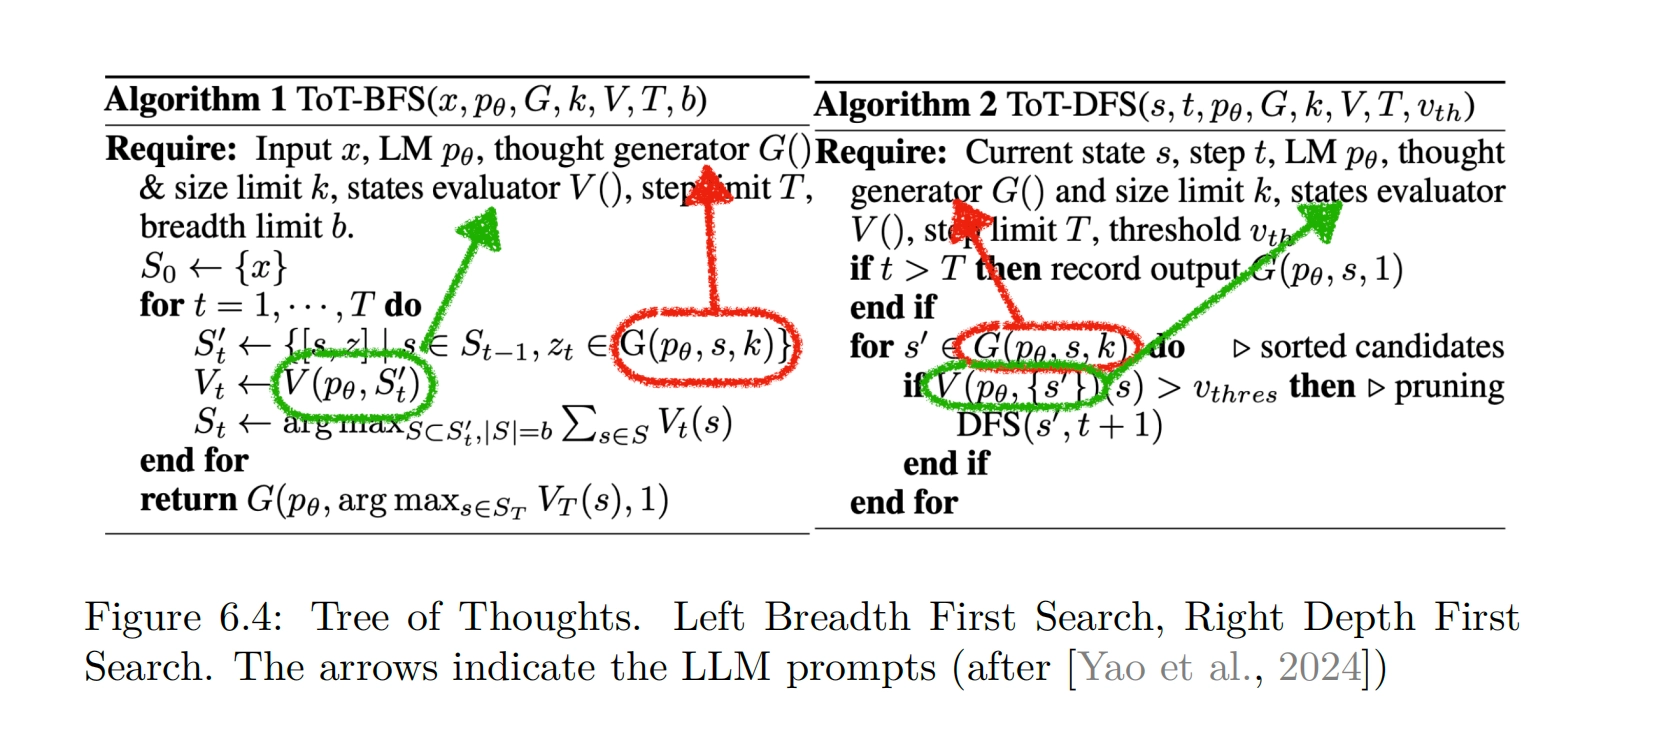
BFS 保留每一层最有希望的状态,DFS 则沿一条分支深入并在失败后回溯。
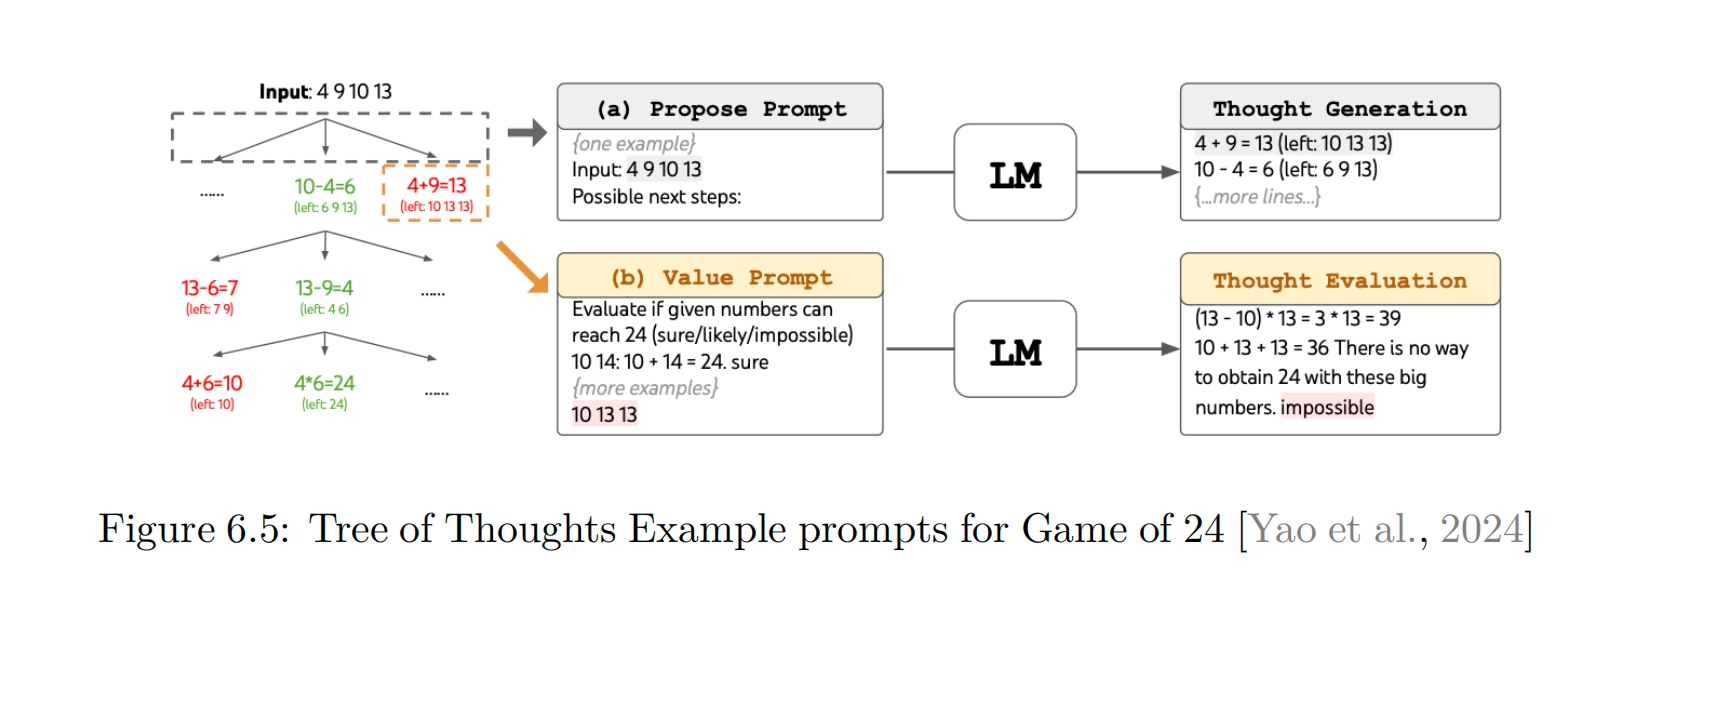
在 Game of 24 中,LLM 既用于提出候选步骤,也用于判断哪些中间结果值得继续搜索。
ToT 的优点是路径可观察、可回退、易于加入约束。它的限制是扩展策略通常由人预先固定:每层生成多少节点、保留多少分支、何时停止都需要配置。学习型策略可以根据状态动态决定下一步探索哪里,但会引入训练、稳定性和调试复杂度。
8. 失败不是结束:Self-Reflection 与长期经验
当 LLM 被分别调用为 Actor、Critic 或 Evaluator,并根据反馈生成新的 Prompt 或策略时,系统表现出一种工程意义上的 Self-Reflection。
需要强调:反思通常不是模型在一次调用中神秘地“自我意识”,而是 外部控制算法多次调用模型、保存轨迹并重组上下文。
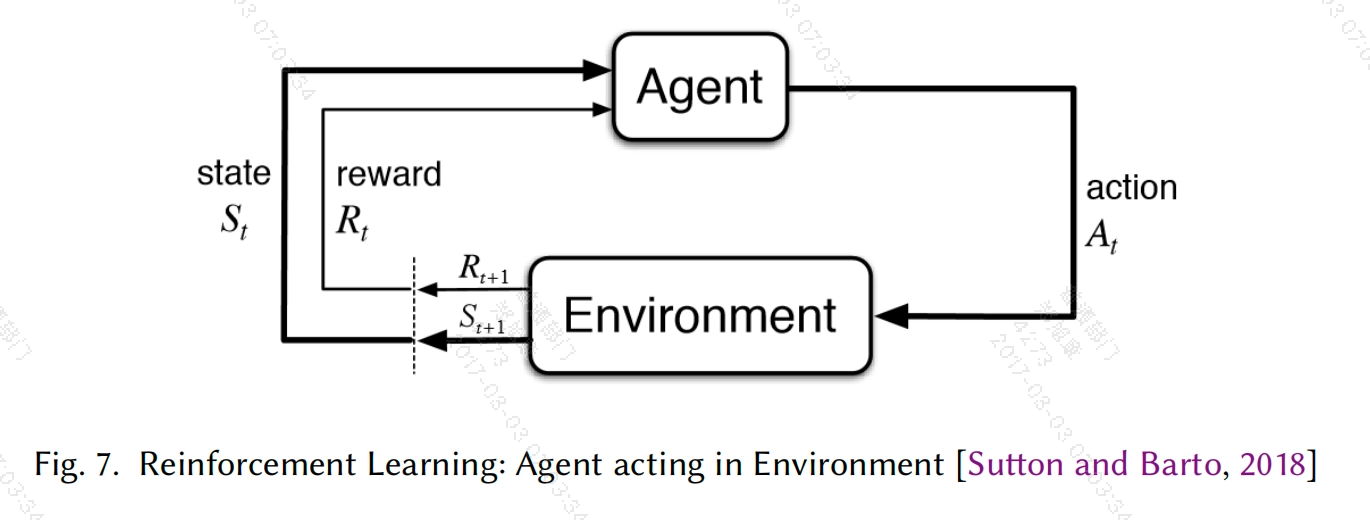
Agent 的动作改变环境,环境再把新状态与奖励返回给下一轮决策。
8.1 Self-Refine
Self-Refine 使用简单循环:
|
|
同一个模型可以同时生成答案、批评答案并据此改写。它不需要更新模型权重,适合能够用语言描述质量标准的任务。
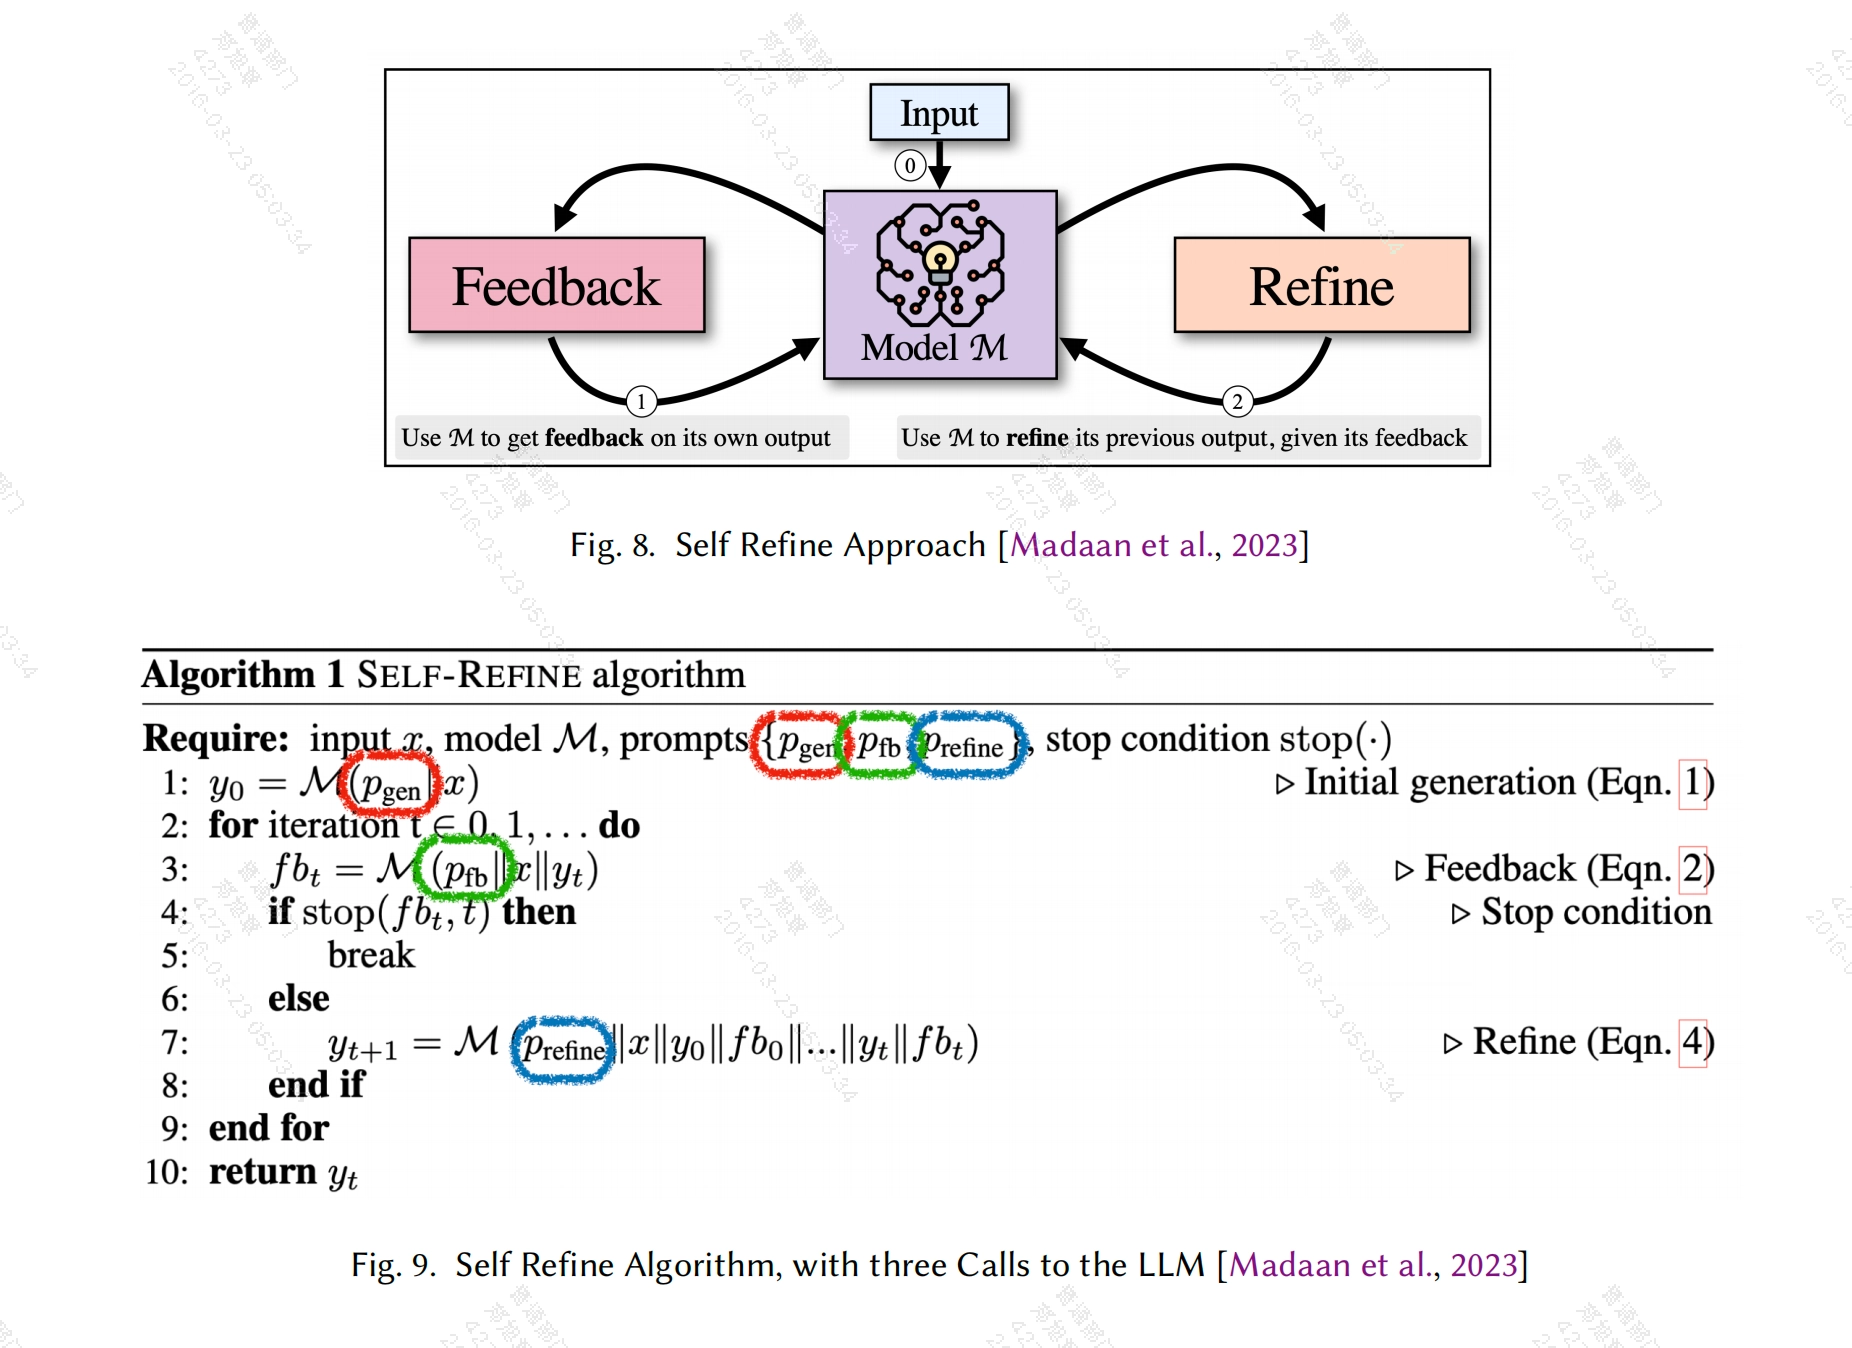
Self-Refine 不更新权重,而是在生成、反馈和改写之间循环。
8.2 ReAct:Reasoning 走向 Action 的桥梁
ReAct 把 Thought、Action 与 Observation 交错组织:
|
|
CoT 只能基于模型已有上下文继续思考;ReAct 可以主动检索 Wikipedia、调用工具或查询环境,再把新证据纳入下一轮推理。它通过 Grounding 减少纯语言推理中的幻觉。
ReAct 已经跨过 Reasoning 与 Action 的边界,因此会成为本系列第二篇的起点。
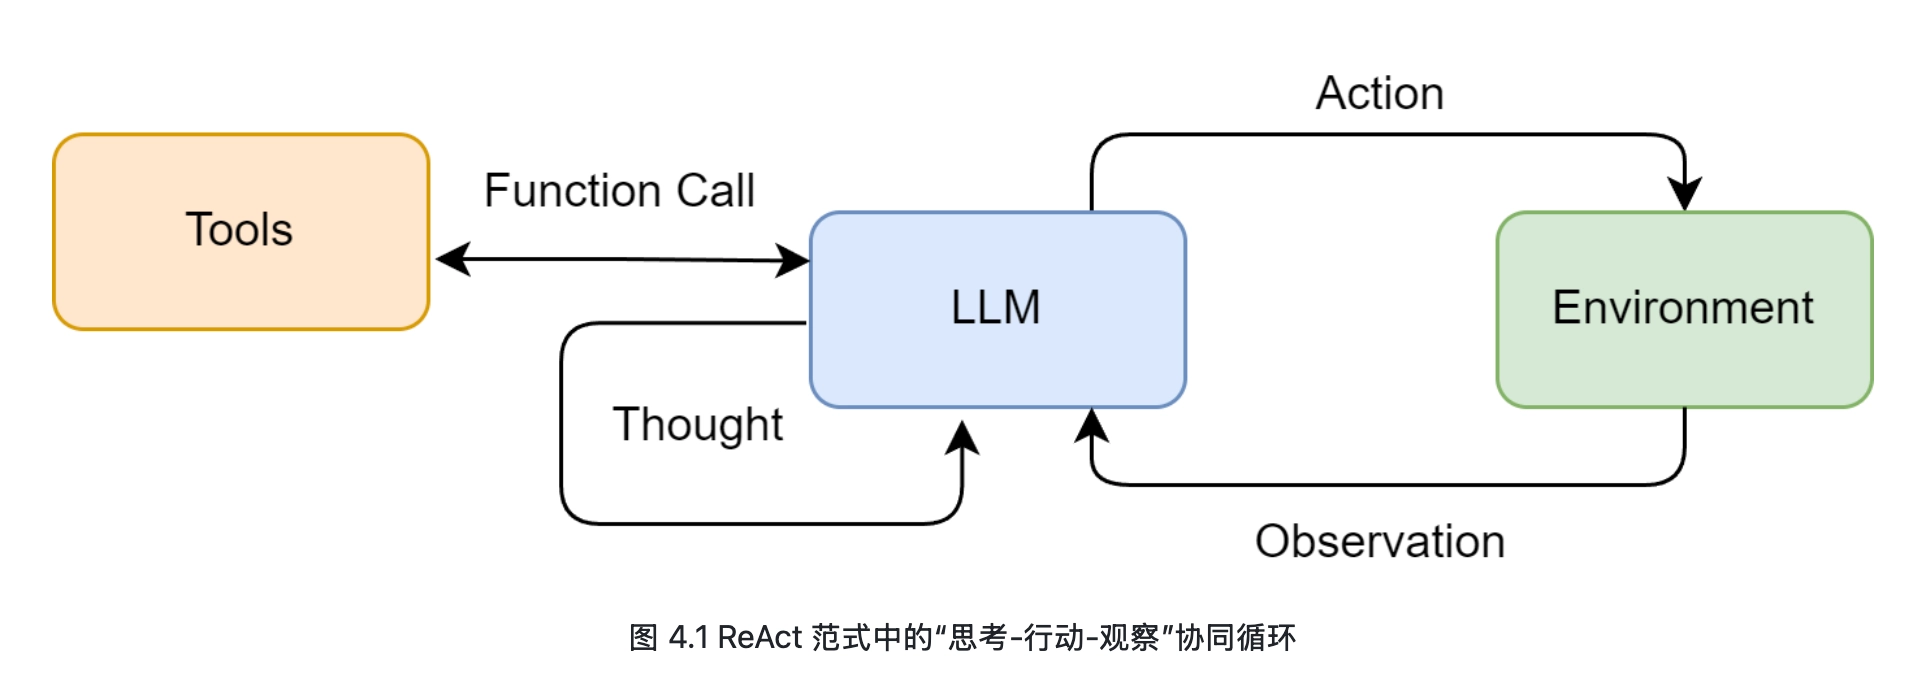
ReAct 把外部观察重新写回推理链,让模型不必只依赖参数中的旧知识。
8.3 Reflexion:从一次轨迹中提炼长期经验
Reflexion 在 ReAct 之外增加三个角色:
- Actor:生成推理、动作与完整轨迹;
- Evaluator:判断任务是否成功并给出反馈;
Reflector:把失败原因压缩成可复用的自然语言经验。
1 2 3 4 5 6 7 8 9Actor trajectory ↓ Evaluator score / feedback ↓ Reflector creates a lesson ↓ Store in memory ↓ Actor tries again
Reflexion 区分两类记忆:短期记忆保存当前推理和行动轨迹;长期记忆保存跨尝试可复用的反思。
例如:
|
|
可以用一句话记住关系:
ReAct = Think → Act → Observe
Reflexion = ReAct → Evaluate → Reflect → Remember → Try Again
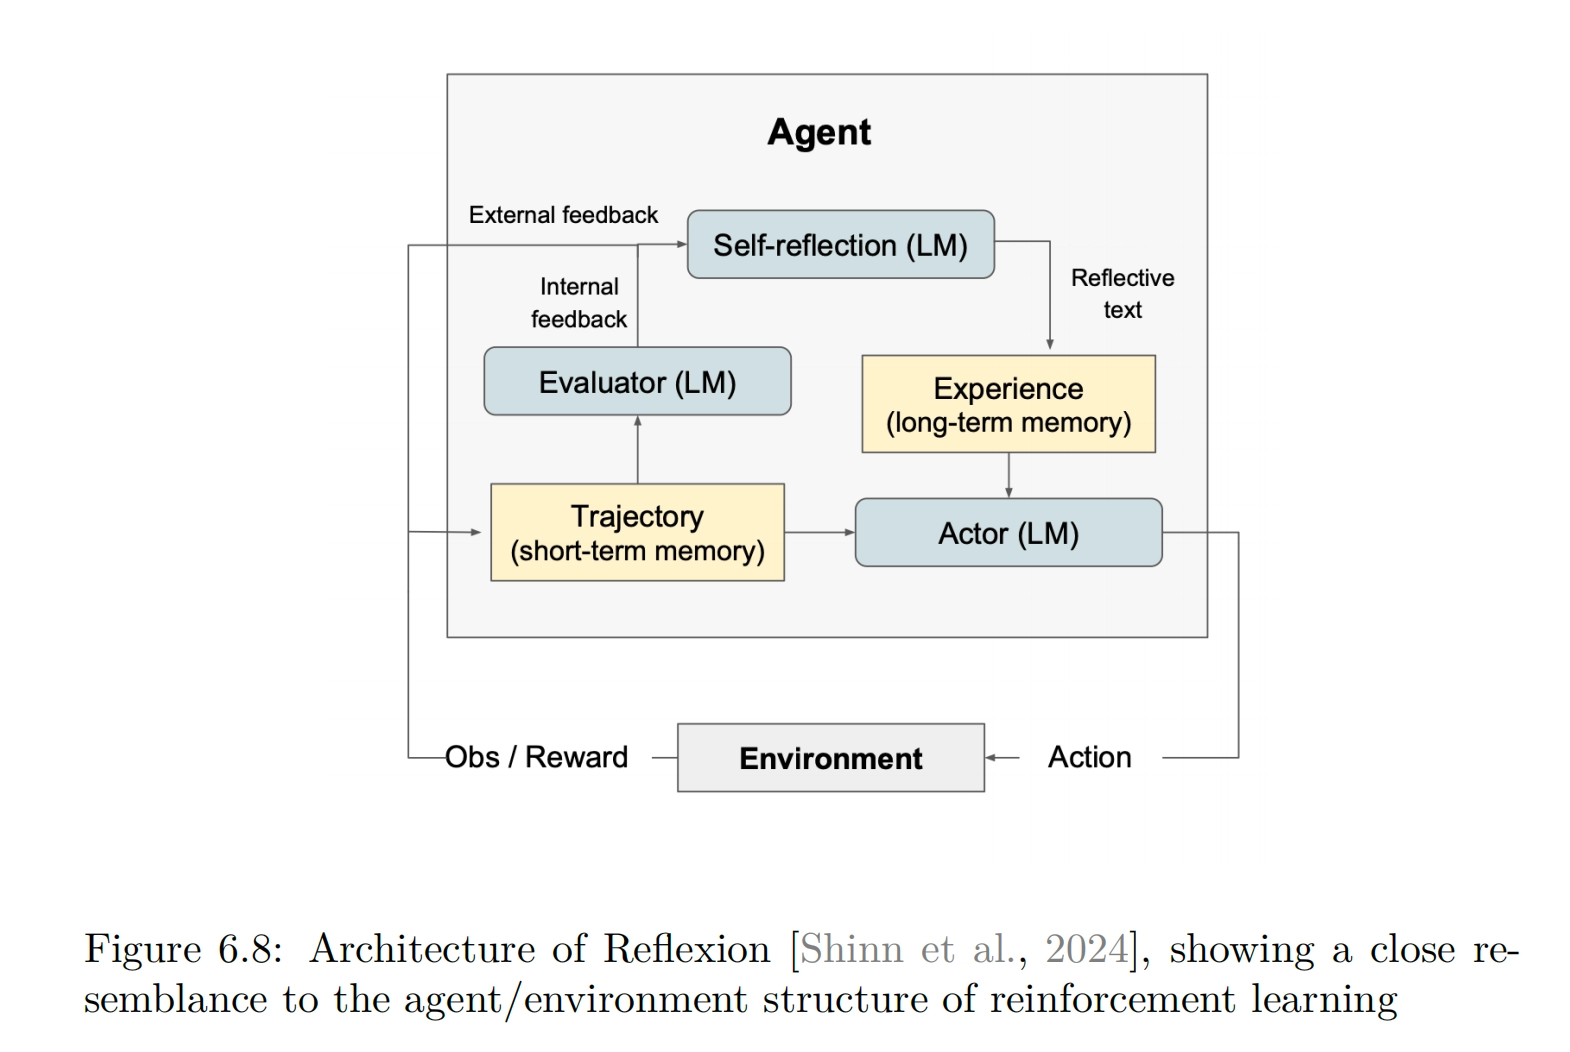
Actor 负责尝试,Evaluator 判断成败,Reflector 再把失败压缩为可复用经验。
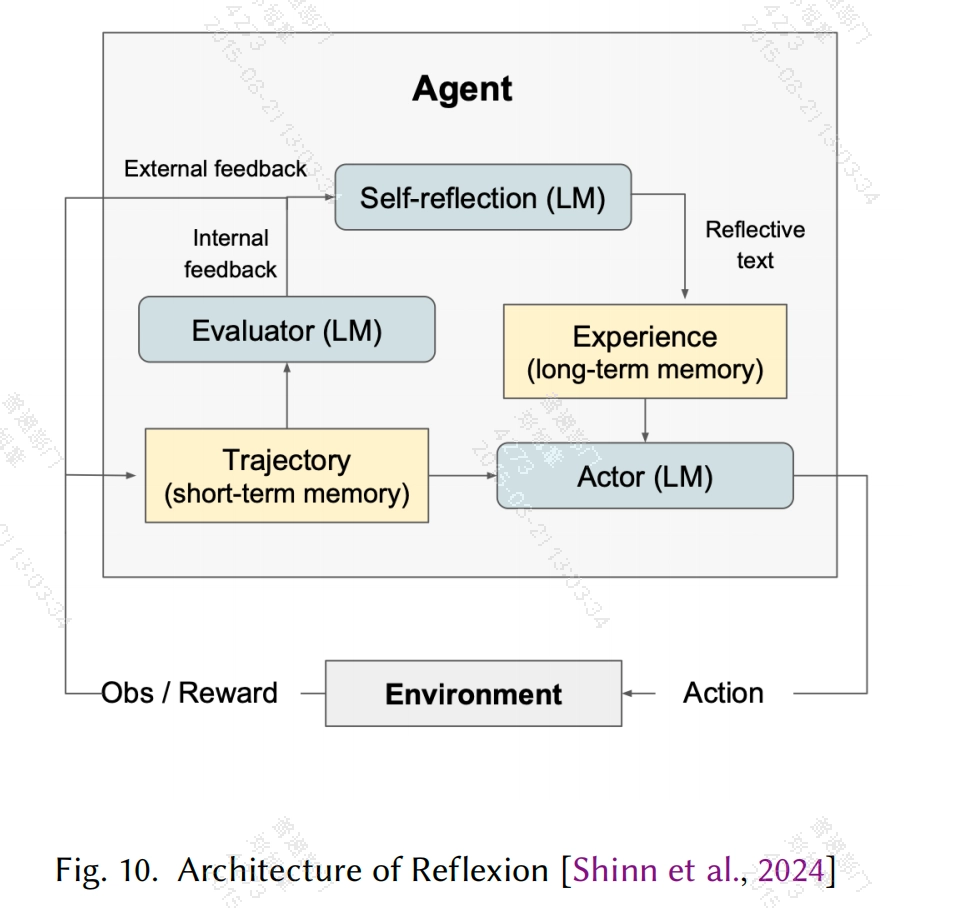
Reflexion 的关键不是“再想一次”,而是区分当前轨迹与跨尝试保留的长期经验。
8.4 Buffer of Thoughts
Buffer of Thoughts 不保存每个问题的完整轨迹,而是把不同任务中的高层解题结构提炼为 Thought Template,存入 Meta-Buffer:
|
|
它试图让 Agent 不必每次从零推理,而是积累类似“先识别约束、再枚举候选、最后验证”的通用认知模式。
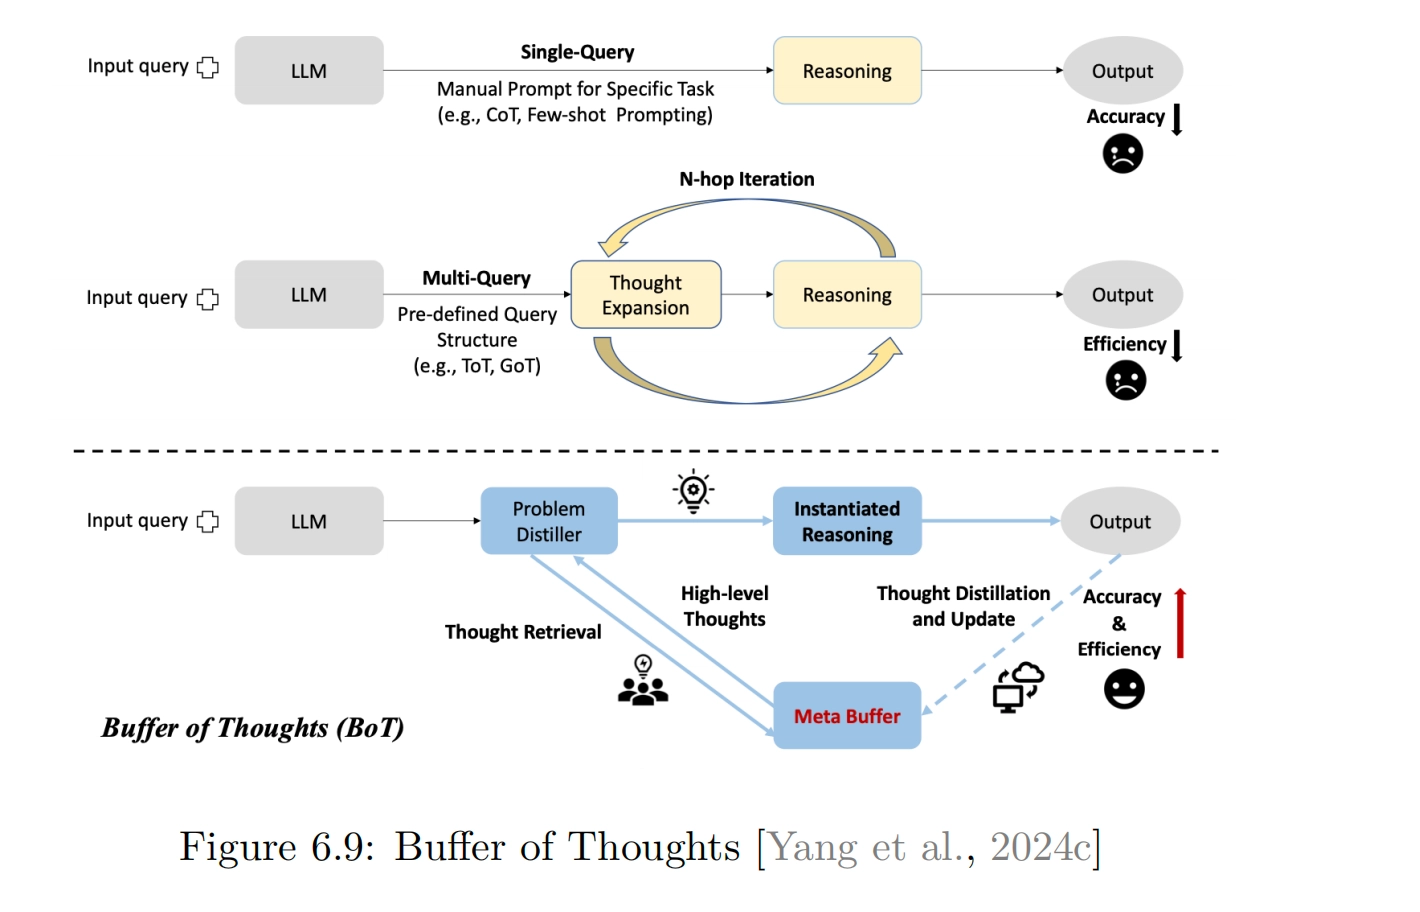
Buffer of Thoughts 保存的是可迁移的解题模板,而不是每个历史问题的全部细节。
8.5 其他 Prompt 改进循环
| 方法 | 核心思想 |
|---|---|
| Progressive Hint Prompting | 把上一轮答案作为新提示的一部分,持续迭代直到稳定 |
| Self-Discover | 从多种 Reasoning Module 中选择并组合适合当前问题的结构 |
| Prompt Improvement | 用评价结果改写下一轮 Prompt,而不是修改权重 |
Self-Reflection 方法有两个共同难点:
- 多个角色和 Prompt 会产生复杂交互,错误可能被循环放大,调试困难;
- 状态、动作、观察、奖励和反思不断增长,最终会挤满 Context Window。
因此,反思必须与摘要、记忆选择、Context Reset 和外部状态存储结合。
9. 推理也需要查资料:Retrieval Augmentation
Reasoning 不应该只在参数记忆中闭门运行。RAG 把非结构化文档、数据库或知识图谱接入推理过程:
|
|
基础 RAG 在回答前固定检索一次;Adaptive Retrieval 则让模型判断何时需要搜索、应该搜索什么,以及当前证据是否足够。
它与 Self-Reflection 的关系很紧密:Evaluator 发现证据不足或内容过期后,可以触发新检索;检索结果又成为下一轮推理的 Observation。由此,Reasoning 开始变成“思考—取证—验证”的动态过程。
10. 把好的推理轨迹写回模型:RLVR 与 GRPO
前面的多数方法发生在推理阶段,不修改参数。但高质量 Reasoning Trace 也可以反过来用于训练。
10.1 RLVR
Reinforcement Learning with Verifiable Rewards(RLVR)使用可以快速、确定计算的验证器代替主观 Reward Model,例如:
- 数学题最终答案是否正确;
- 代码是否通过测试;
- 格式和约束是否满足;
定理证明是否能被 Proof Checker 接受。
1Prompt → Sample Reasoning + Answer → Verifier → Reward → Policy Update
它的优势是 Reward 更客观、规模化成本更低;局限是只有一部分现实任务拥有便宜且可靠的验证函数。
若验证器为轨迹 $\tau$ 返回可验证奖励 $R(\tau)$,训练目标可以简写为:
10.2 GRPO
Group Relative Policy Optimization(GRPO)针对同一问题采样一组回答,根据组内相对得分估计优势,减少对独立 Critic Model 的依赖。它把 Self-Consistency 的“多样采样”进一步用于训练:不仅在推理时选出更好答案,也让模型增加高奖励推理策略的概率。
对组内第 $i$ 个回答,一个直观的相对优势估计是:
这形成一个循环:
|
|
11. 统一视角:模型生成候选,系统提供结构与反馈
LLM 属于 Connectionist AI:知识与能力分布在神经网络参数中,通过数据学习模式。搜索、逻辑、规划、解释器和状态机则更接近 Symbolic AI:知识和操作规则被显式表达。
现代 Agentic System 往往结合两者:
|
|
这也常被类比为 System 1 与 System 2:
- Fast Reasoning:直接依靠已学习的关联给出答案;
- Slow Reasoning:显式引入中间步骤、搜索、规划和工具。
例如:
|
|
但这个类比不能过度解释。LLM 仍然通过 Next-token Prediction 运行;“慢思考”更准确的工程描述是:系统为模型提供了更多串行 Token、并行候选、外部状态和可验证反馈。
12. Reasoning 之后:Action 与 Interaction
到这里,我们得到一条从普通生成到 Agentic Reasoning 的完整路径:
|
|
但 Reasoning 本身不能改变世界。一条正确计划如果无法调用工具,就仍然只是文本;一次行动如果不能读取环境结果,也无法形成闭环。
因此接下来的两篇会讨论:
- Action:Planning、Tool Use、World Model、Vision-Language-Action Model,以及模型如何把 Token 转成真实操作;
- Interaction:Observation、环境反馈、多 Agent 协作、状态管理与持续学习。
Reasoning 决定“下一步应该做什么”,Action 决定“如何做”,Interaction 则让系统知道“做完之后发生了什么”。三者结合,才构成真正的 Agentic Large Language Model。
参考资料
- Chain-of-Thought Prompting Elicits Reasoning in Large Language Models
- Self-Consistency Improves Chain of Thought Reasoning in Language Models
- PAL: Program-Aided Language Models
- Teaching Large Language Models to Self-Debug
- Tree of Thoughts: Deliberate Problem Solving with Large Language Models
- Self-Refine: Iterative Refinement with Self-Feedback
- ReAct: Synergizing Reasoning and Acting in Language Models
- Reflexion: Language Agents with Verbal Reinforcement Learning
- Buffer of Thoughts: Thought-Augmented Reasoning with Large Language Models
- DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models
文章作者 zhengxz
上次更新 2026-09-29