Stanford CS329A:Self-Improving AI Agents 的完整技术框架
文章目录
Self-Improving AI Agent 并不是一个会无限递归修改自己的神秘系统。更实际的理解是:Agent 在生成、行动、观察和验证之间形成闭环,把推理时获得的反馈用于改进当前答案、后续决策,甚至下一轮训练。
这篇文章沿着 Stanford CS329A 的课程主线,把测试时计算、验证器、工具反馈、规划搜索、强化学习、深度研究与长程评测串成一个完整框架。
课程:Stanford CS329A · Self-Improving AI Agents
核心问题:如何让 Agent 从自己的尝试与环境反馈中学习,而不只是依赖更多人工标注?
1. 什么是 Self-Improving Agent?
一个可以自我改进的 Agent,至少需要完成下面这个闭环:
- Generate / Act:生成候选答案,或在环境中执行动作;
- Observe / Verify:读取工具结果、执行反馈或验证器评分;
- Select / Reflect:选择更好的轨迹,分析失败原因并修正;
- Update:更新上下文、记忆、搜索策略,或者模型参数;
- Evaluate:在独立任务上确认改进是否真实存在。
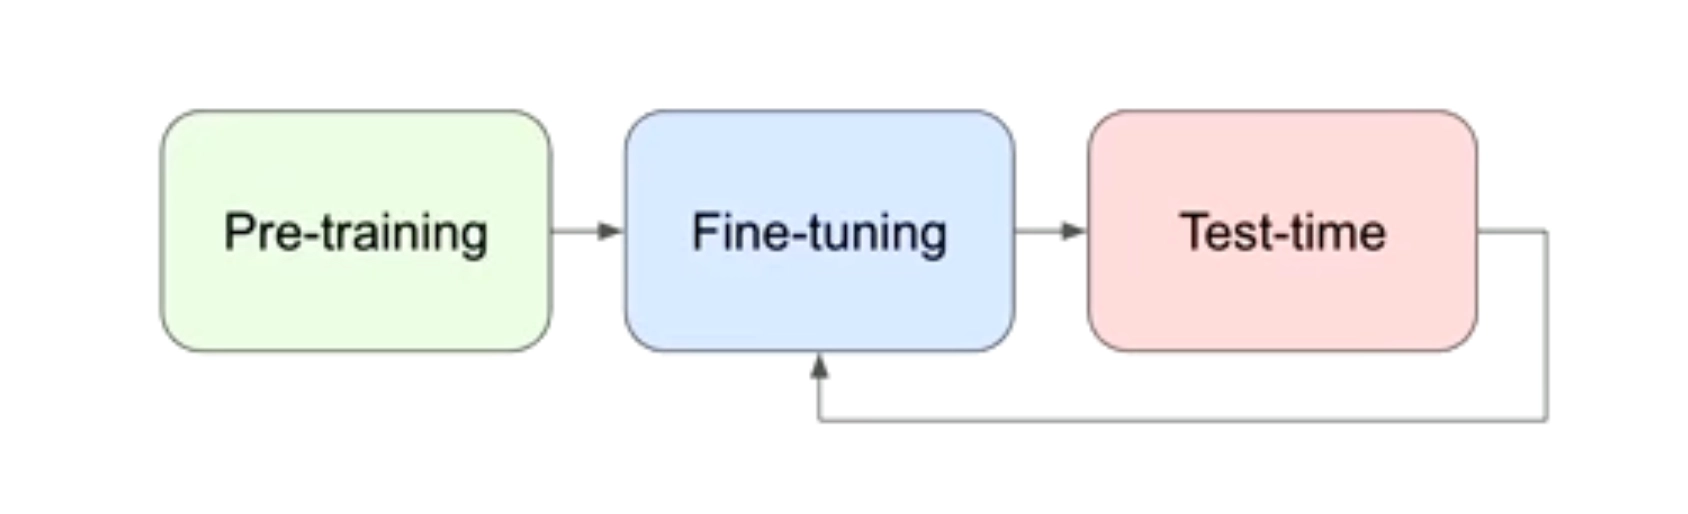
这个框架里有两种不同的“扩展”:
- Test-time scaling:模型参数不变,在回答一个问题时投入更多采样、搜索和验证计算;
- Train-time scaling:把成功与失败轨迹变成训练信号,通过监督学习或强化学习更新模型。
前者解决“这一次怎样答得更好”,后者解决“下一次怎样更容易答好”。真正的自我改进系统通常会把两者连接起来。
2. 测试时计算扩展:不要只生成一次
最简单的测试时扩展是 Repeated Sampling:对同一道题独立生成多个候选答案,再从中选择一个。
如果单次生成正确答案的概率为 $p$,并且各次采样近似独立,那么生成 $k$ 次后,至少出现一个正确答案的概率是:
$$ \mathrm{pass@}k = 1-(1-p)^k $$
这说明即使模型参数不变,只要增加采样次数,候选集合的 Coverage 就可能提高。Large Language Monkeys 的实验中,DeepSeek-Coder-V2-Instruct 在当时 SWE-bench Lite 上的单次成功率为 15.9%,采样 250 次后的问题覆盖率达到 56%。
但 coverage 高不等于最终结果好。系统还必须在多个候选中识别正确答案,也就是提高 Precision。如果选择器只会多数投票,而错误答案恰好高度相似,那么再多采样也未必有用。
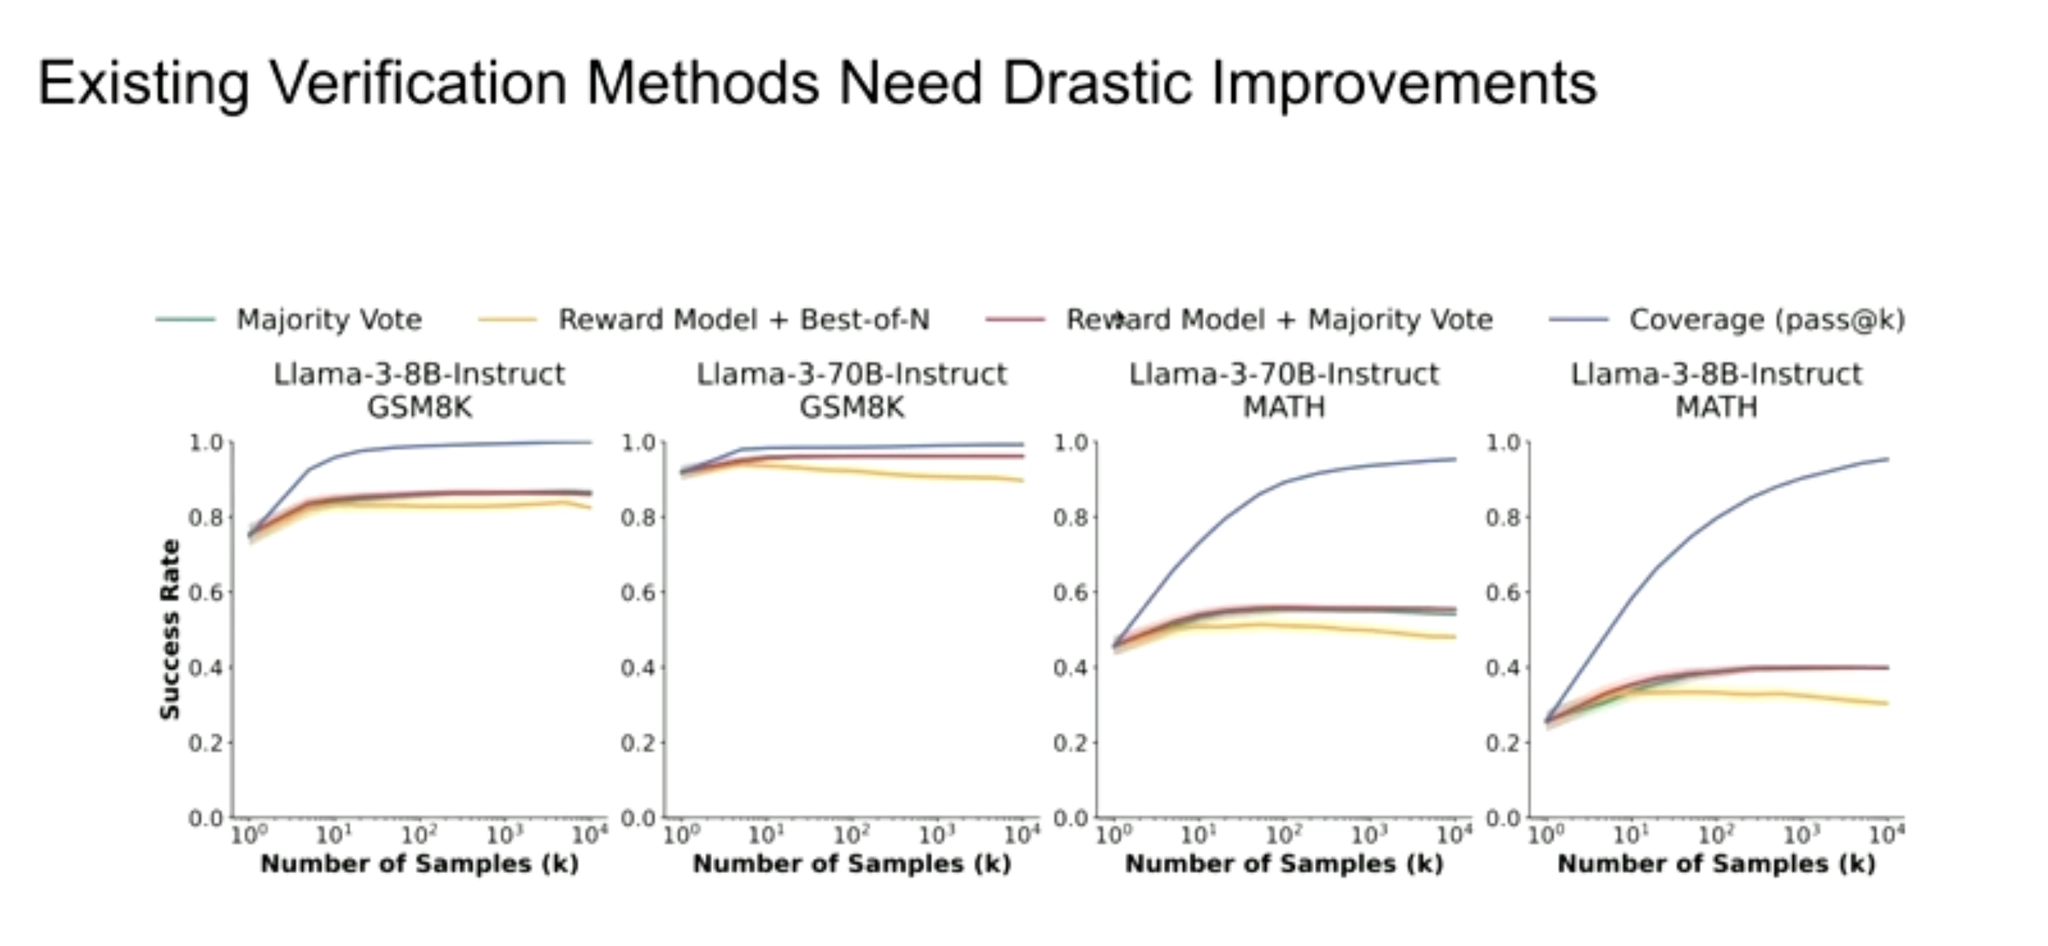
因此,测试时计算扩展真正包含两个问题:
- 生成问题:能不能探索到正确解?
- 选择问题:看见正确解以后,能不能把它选出来?
三种常见策略
2.1 并行采样:Best-of-N
同时生成 $N$ 个彼此独立的候选,用规则、测试用例或奖励模型给它们打分,返回得分最高的结果。它简单、并行度高,适合有可靠验证器的任务。
2.2 顺序修正:Sequential Revisions
每一步都基于上一版答案和反馈继续修正。它更像调试:先生成,再定位问题,再修改。优点是能够复用已有工作;缺点是早期错误可能把后续推理锁在错误路径上。
2.3 搜索:Beam Search / Tree Search
保留多条中间推理轨迹,在每一步扩展并剪枝。相比只评价最终答案,搜索需要验证器判断“当前这一步是否值得继续”。
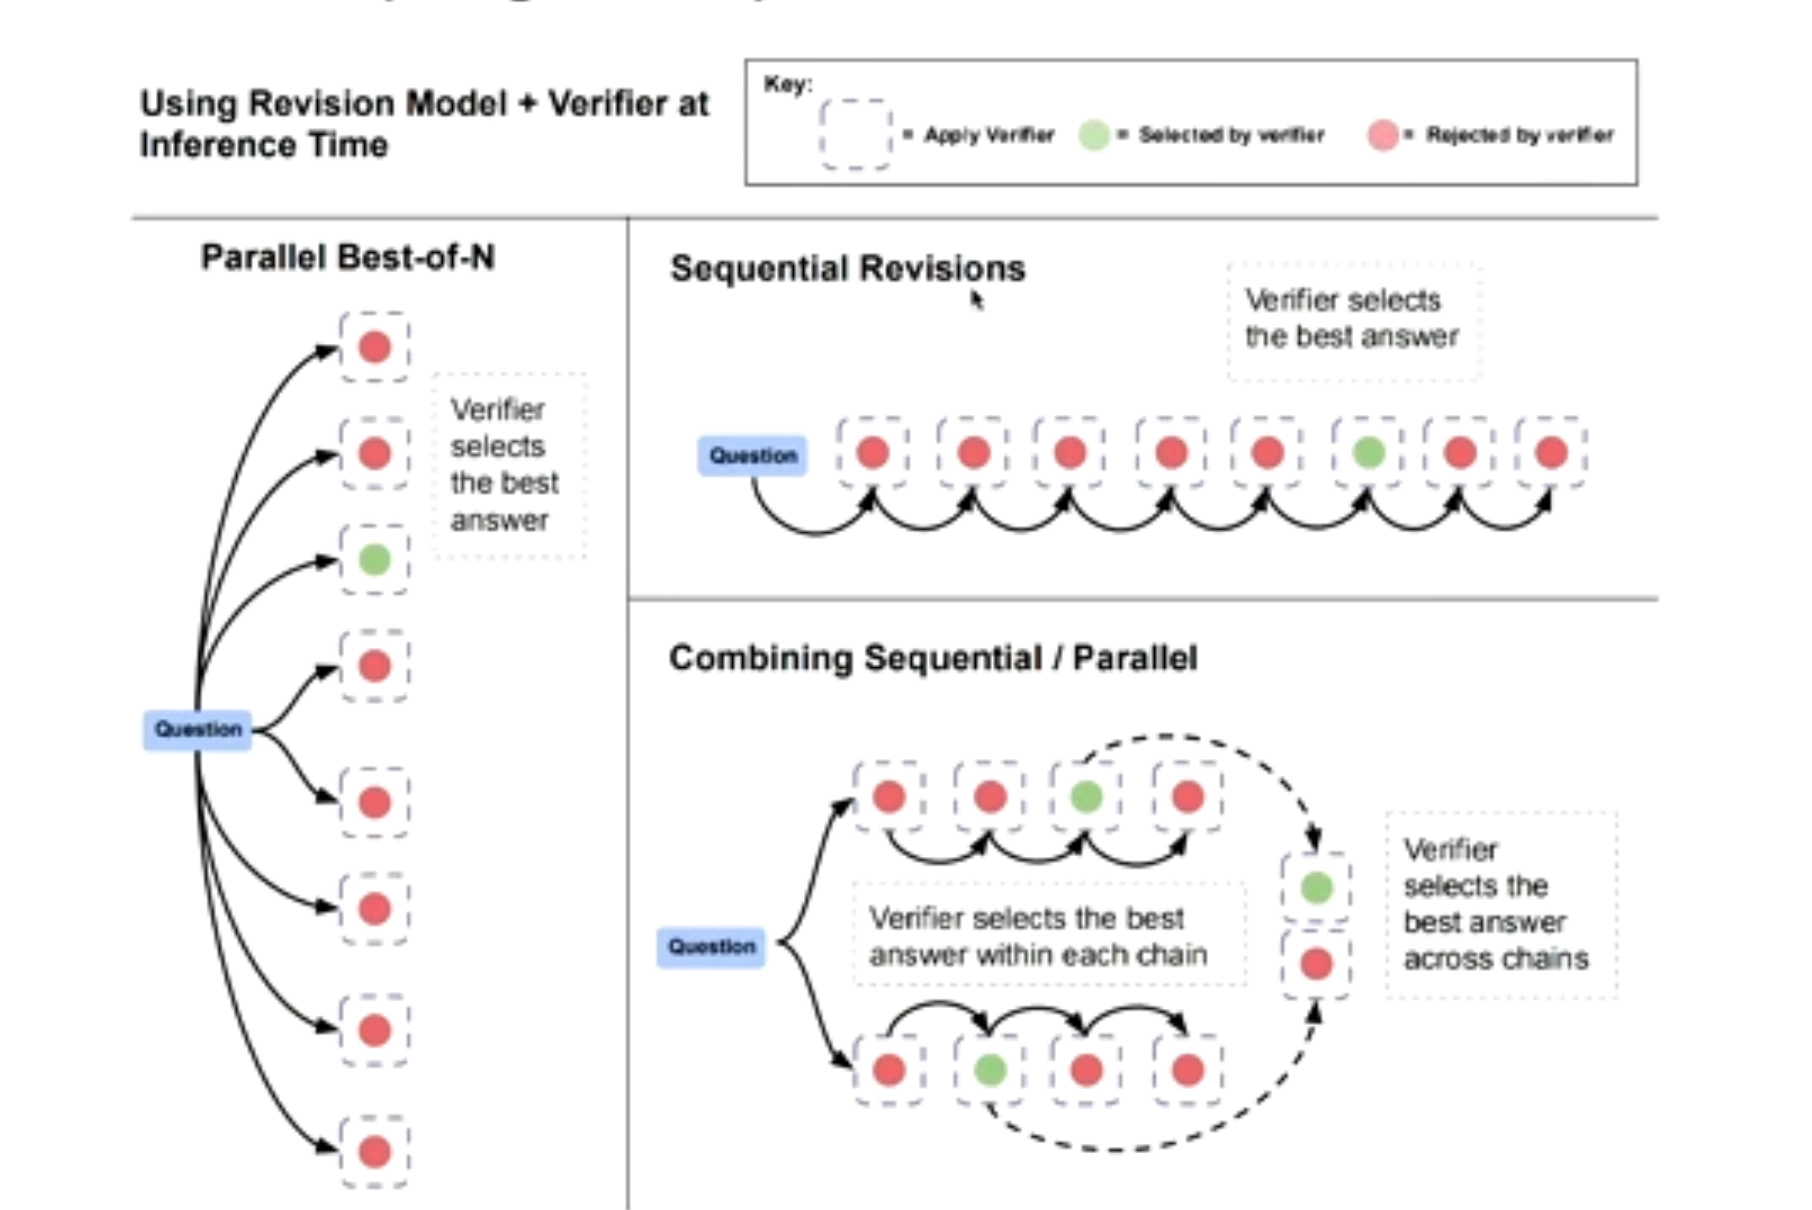
最好的策略不一定是固定生成同样多的样本。Compute-optimal scaling 会根据问题难度分配预算:简单题很快停止,中等难度题投入更多搜索;如果最难问题的候选中几乎从不出现正确答案,那么继续增加采样的边际收益会迅速下降。
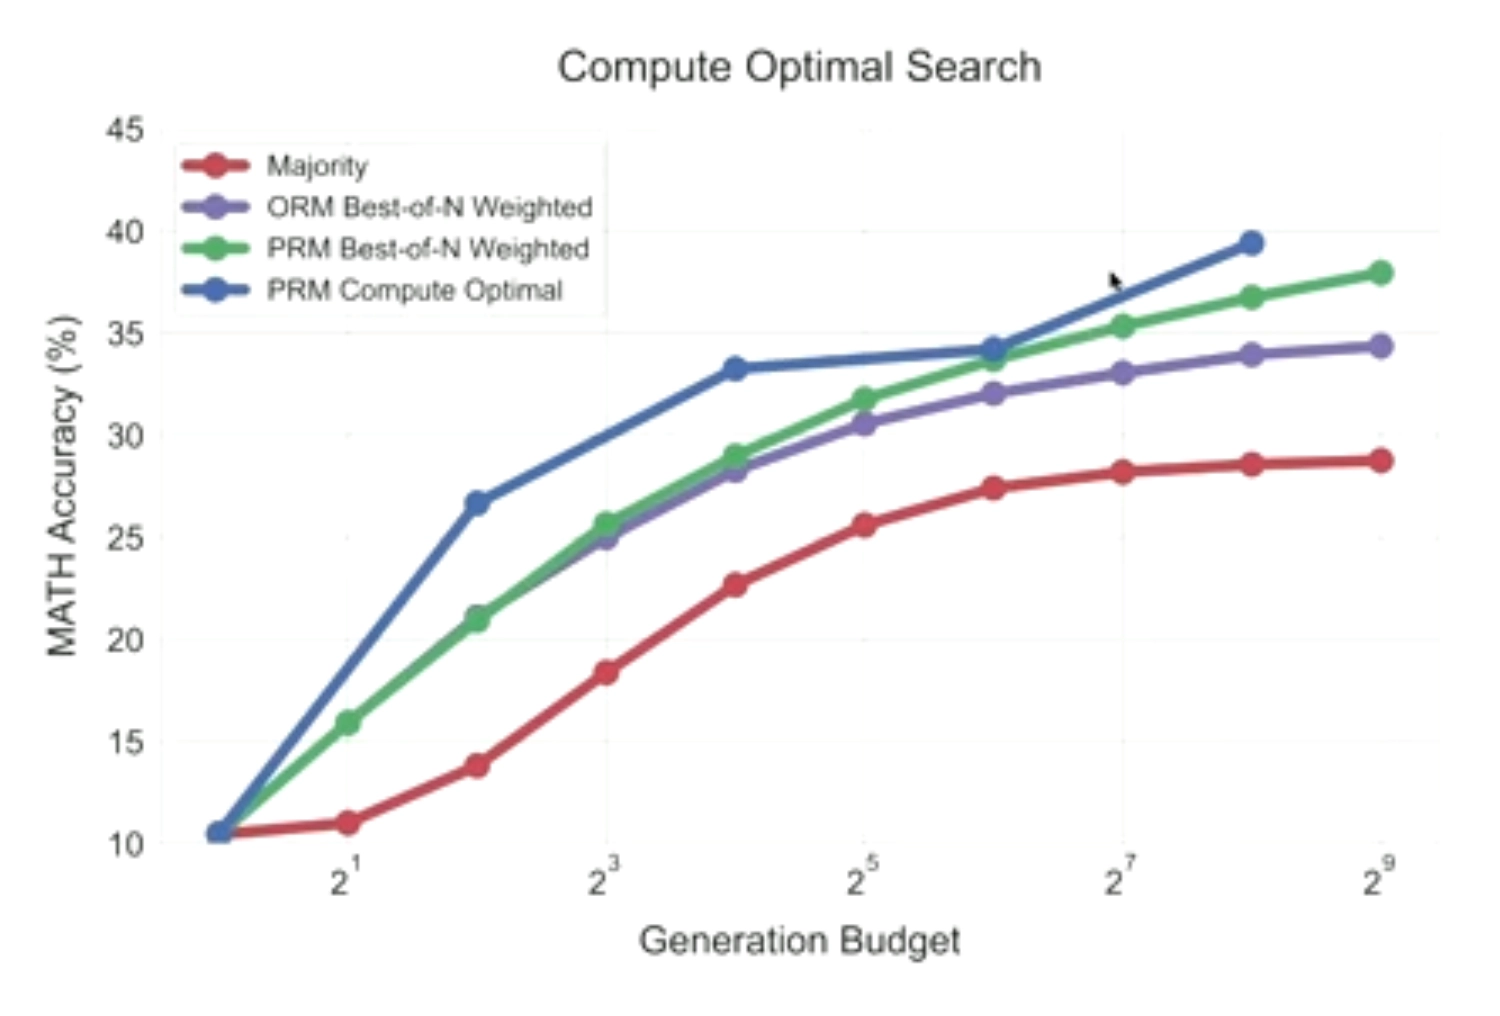
这也解释了一个看似矛盾的现象:在部分问题上,小模型加测试时计算可以超过大得多的模型;但在模型能力边界之外,增加计算无法凭空创造不存在的解题能力。
3. 验证器:自我改进系统的瓶颈
验证器接收问题、候选答案,有时还包括完整推理轨迹,然后估计答案正确的概率。
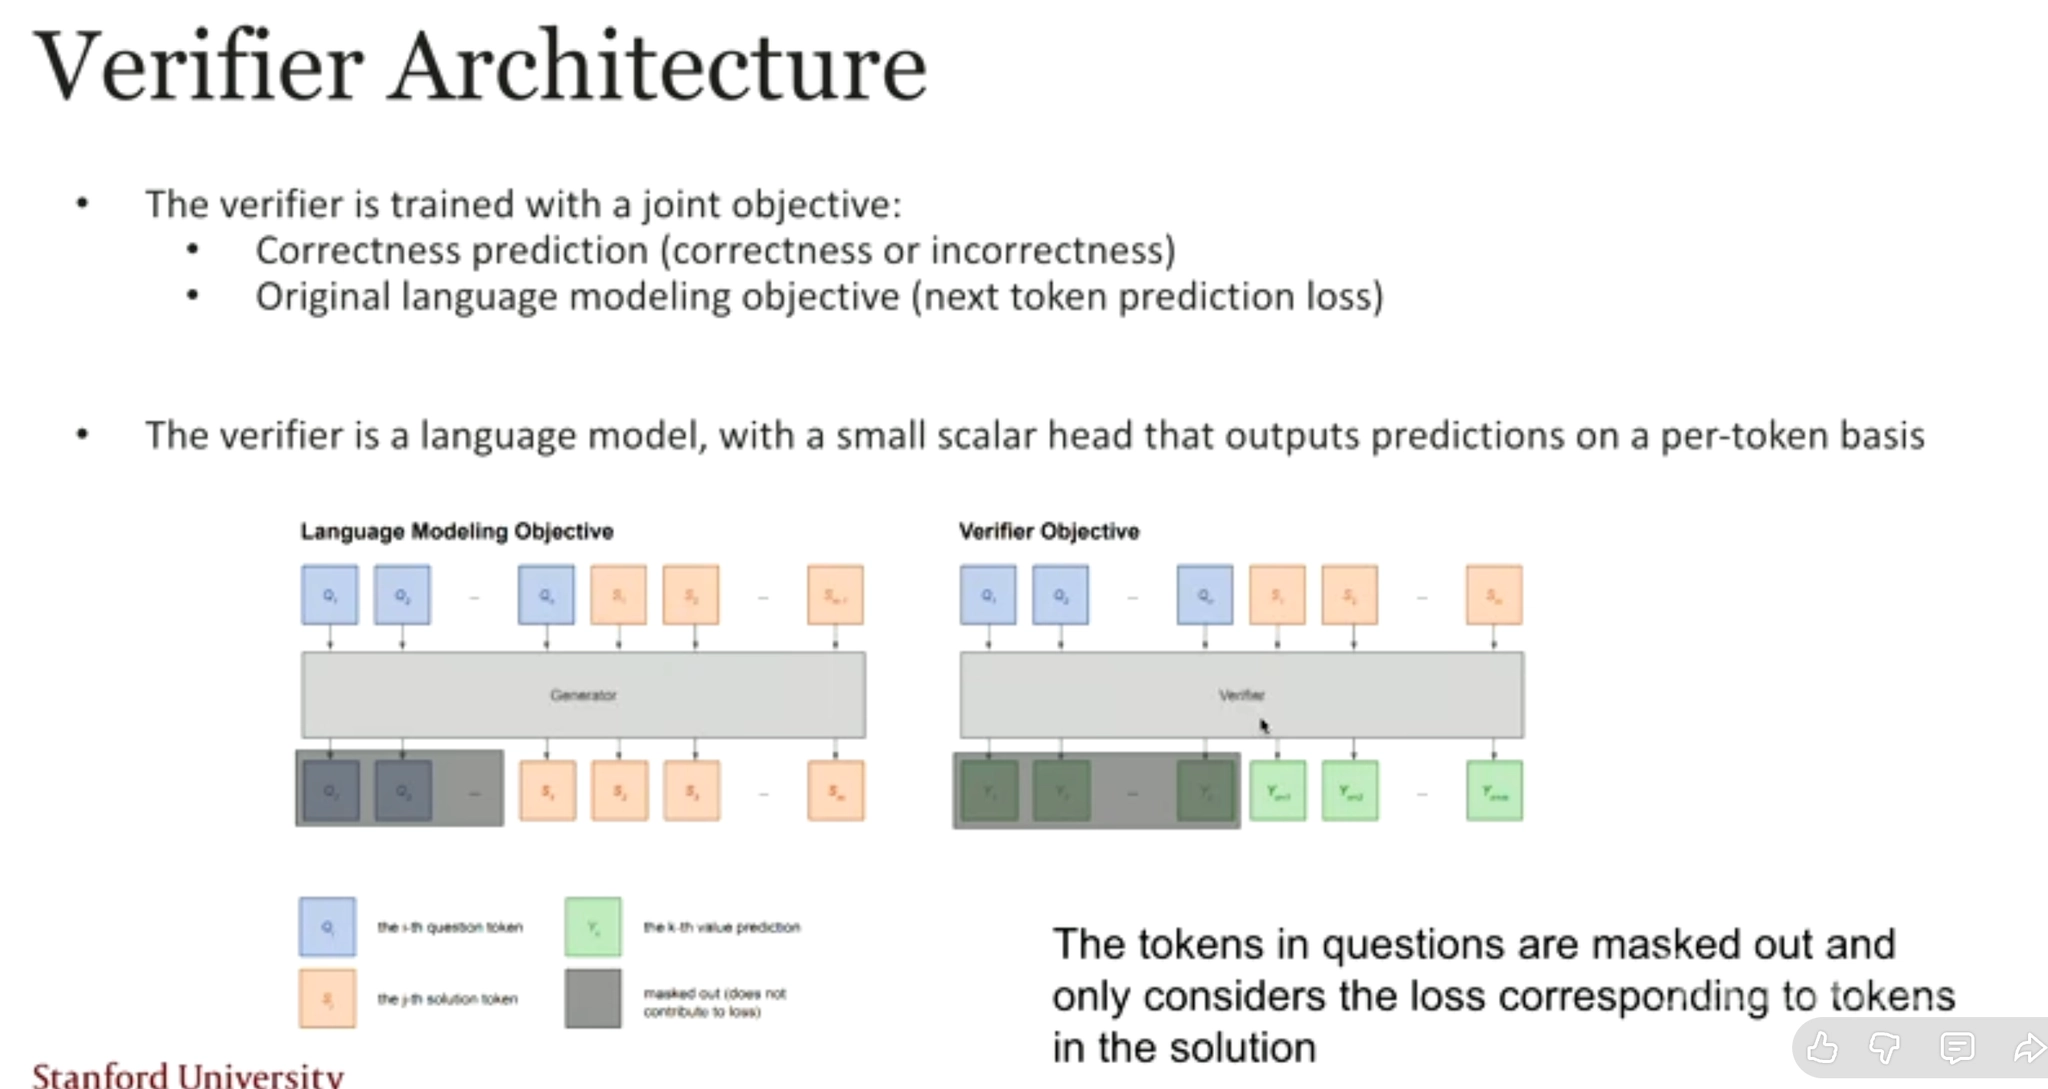
最常见的两类学习式验证器是:
- Outcome Reward Model(ORM):只评价最终答案;
- Process Reward Model(PRM):评价中间推理步骤,为每一步提供信号。
ORM 的标注和使用都比较简单,但它无法区分“推理正确”和“碰巧答对”。PRM 可以把错误定位到某一步,改善长推理链中的 credit assignment,也更容易解释为什么一条轨迹被保留或剪枝。在 Let’s Verify Step by Step 的数学推理实验中,过程监督优于结果监督;这是一项具体实验结论,并不意味着 PRM 在所有任务上都天然占优。
验证器为什么会失败?
- 训练数据太小:验证器记住表面模式,却没有学会判断正确性;
- 生成—验证差距:生成器能产出正确答案,验证器却认不出来;
- Reward hacking:Agent 学会迎合评分规则,而不是完成真实目标;
- 同源偏差:生成器和验证器共享相似盲点,错误会被稳定放大;
- 分布偏移:在短题上训练的验证器,不一定能判断长程任务。
工程上应优先使用更可靠的外部信号:代码单元测试、编译器、形式化证明、数据库约束或环境状态。学习式 verifier 更适合补充这些信号,而不是在存在确定性检查时取代它们。多个较弱验证器的聚合也能缩小生成—验证差距,但前提是它们的错误不完全相关。
4. 工具与环境反馈:让推理接触现实
只在模型内部“思考”,很容易让错误前提一路传递。工具调用把推理连接到外部世界:浏览器可以检索事实,代码解释器可以运行程序,数据库可以返回真实记录,环境则能告诉 Agent 一个动作是否有效。
WebGPT 展示了语言模型如何通过浏览器搜索与引用信息。ReAct 进一步把 Reasoning 与 Acting 交错在同一条轨迹中:
|
|
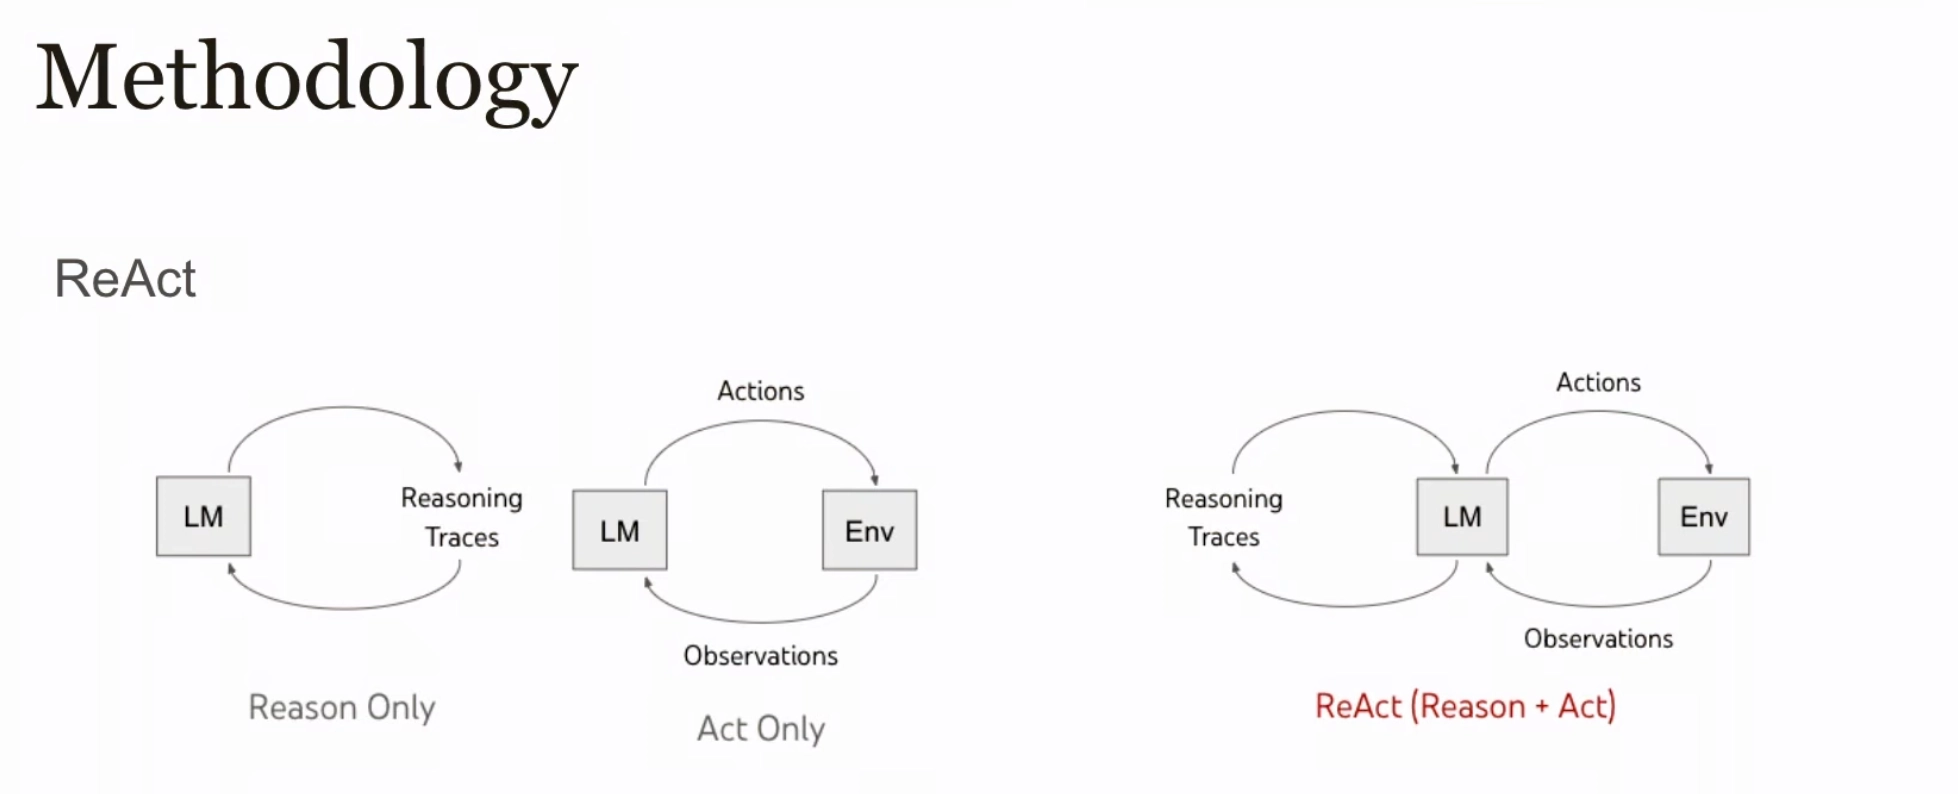
这种模式的关键不是“会调用工具”,而是让 observation 真正改变后续决策。如果 Agent 无论工具返回什么都坚持原计划,那么工具只是一种装饰。
代码任务尤其适合从环境反馈中学习:编译错误、测试结果和运行时异常都能提供比“答案好不好”更具体的信号。RLEF 等工作进一步用执行反馈训练模型学习多步修正。不过,执行环境也带来新的风险:不可信代码必须隔离运行,工具输出可能含有噪声或提示注入,测试用例本身也可能不完整。
5. 规划与多步推理:搜索一棵行动树
长程 Agent 任务不是一次问答,而是一系列互相依赖的决策。前一步会改变环境,后一步只能基于新的状态继续。只沿单一路径向前,很容易因为一个局部错误导致整条任务失败。
LATS(Language Agent Tree Search)把 Agent 的行动轨迹组织成树,并借鉴 Monte Carlo Tree Search:
- Selection:根据价值与探索奖励选择节点;
- Expansion:生成多个可能的下一步动作;
- Evaluation:结合模型价值判断和环境反馈评分;
- Backpropagation:把结果沿路径回传;
- Reflection:总结失败原因,影响后续搜索。
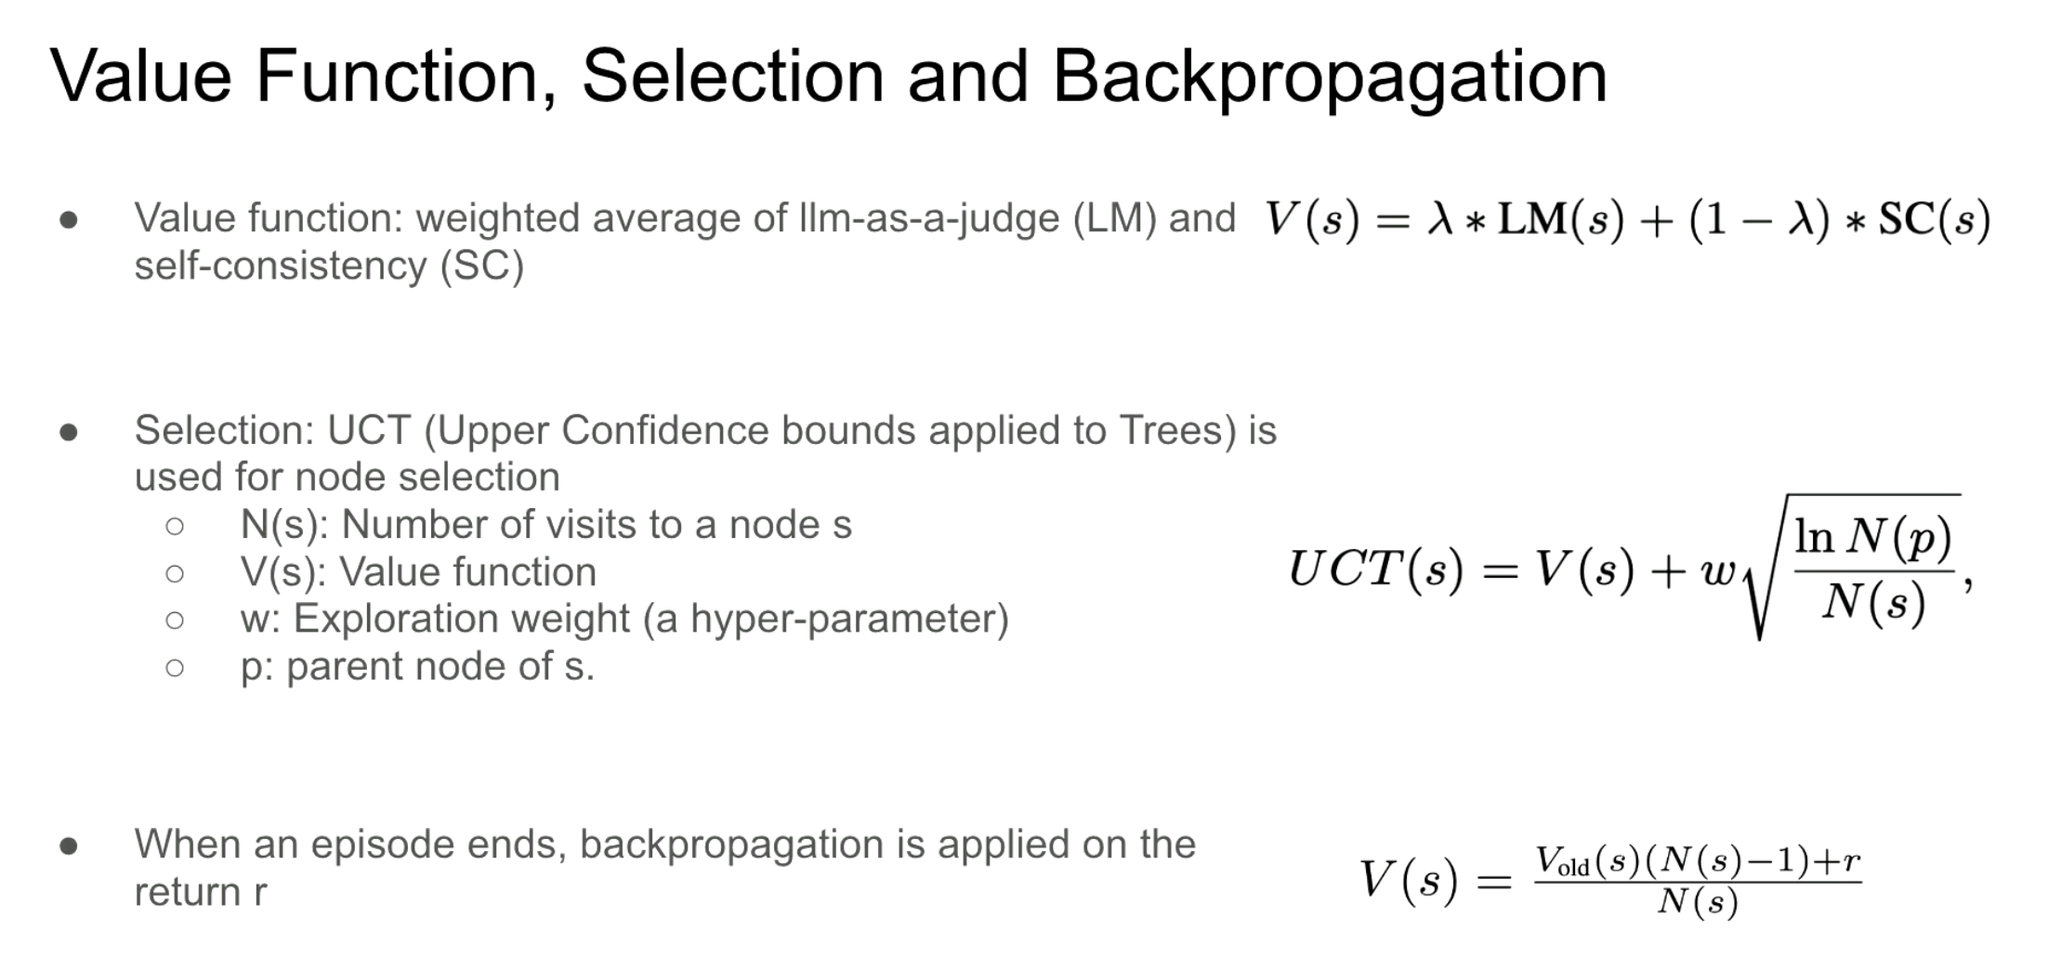
常见的 UCT 形式是:
$$ \mathrm{UCT}(i)=\bar{X}_i+c\sqrt{\frac{\ln N}{n_i}} $$
其中 $\bar{X}_i$ 表示节点的平均价值,$N$ 是父节点访问次数,$n_i$ 是当前节点访问次数,$c$ 控制 exploitation 与 exploration 的平衡。
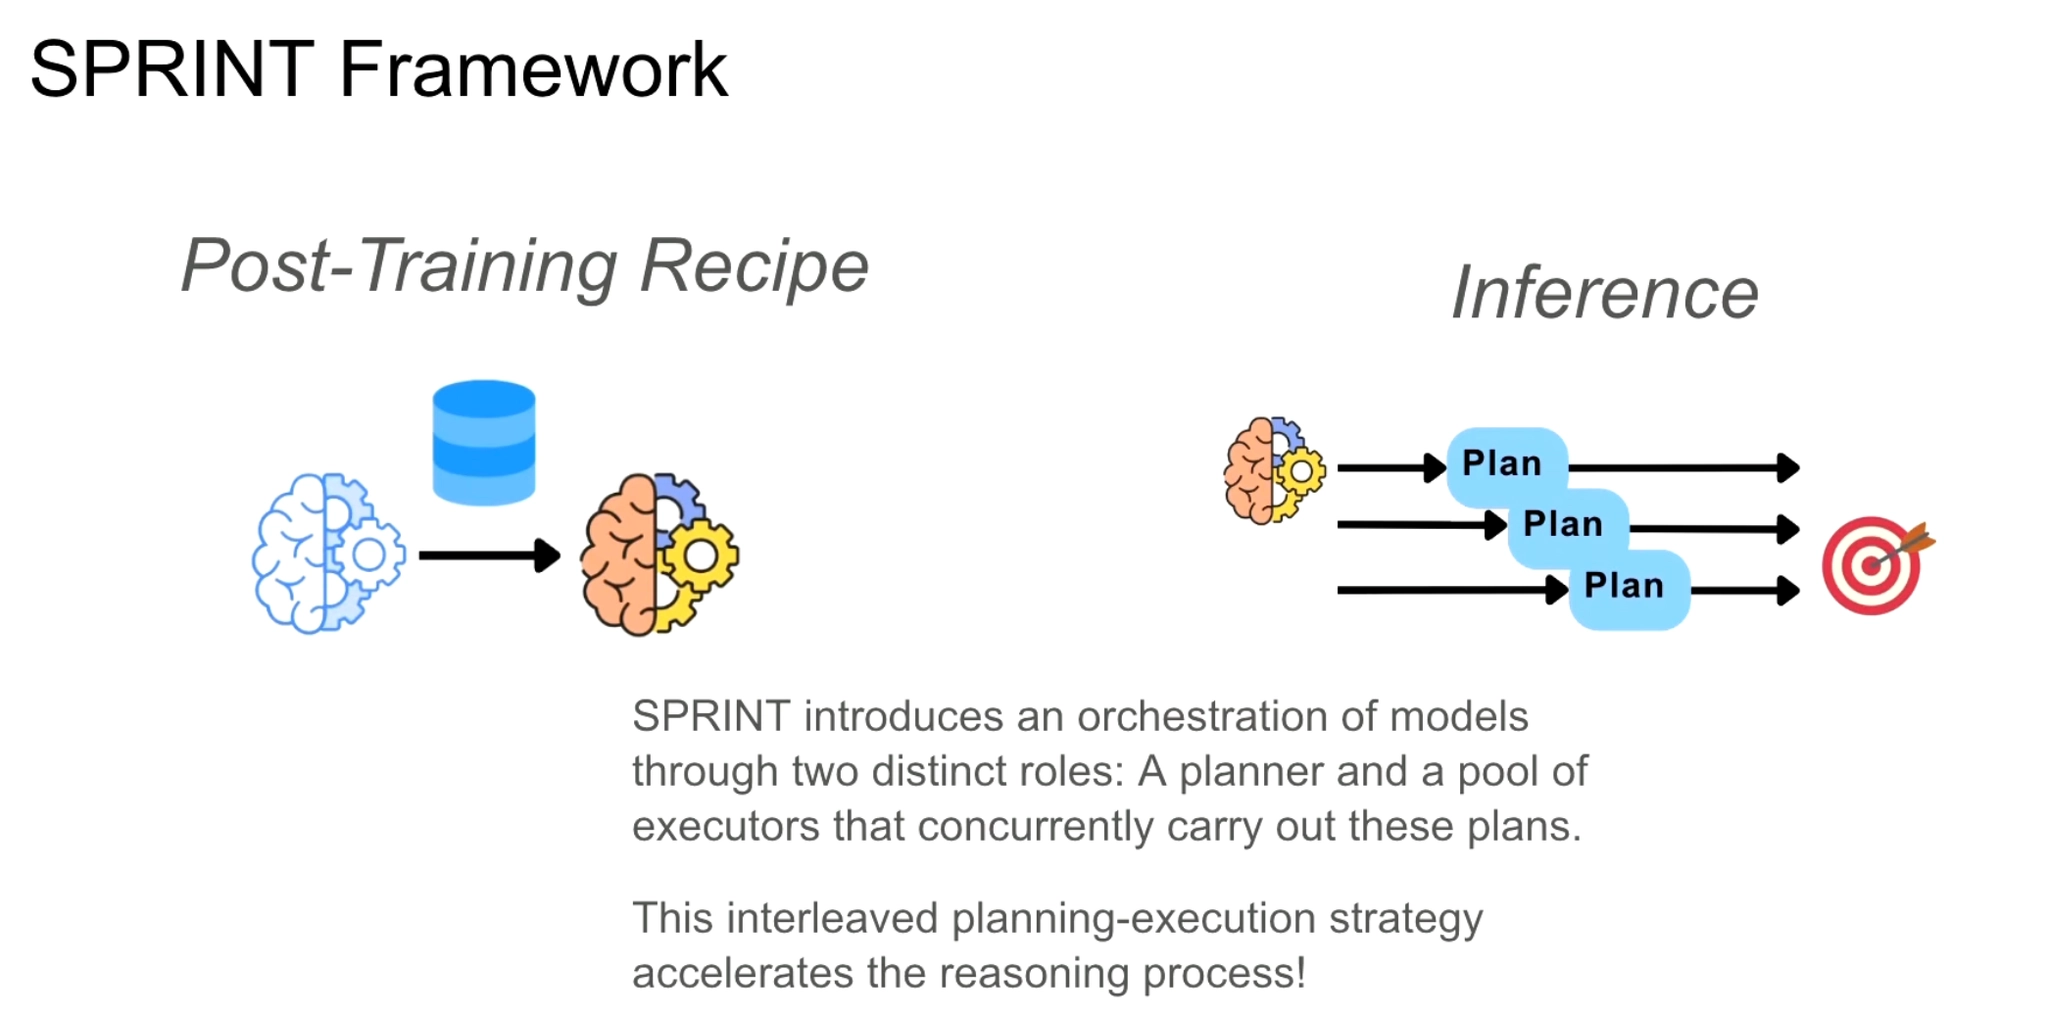
树搜索并非免费午餐。它只有在评价器能比较可靠地区分路径质量时才值得投入;弱判别器会让搜索把更多算力花在错误方向上。对于可以拆成独立子任务的问题,也可以使用 planner 先分解计划,再让多个 executor 并行执行,最后汇总结果。
6. 从测试时扩展走向训练时扩展
测试时搜索会产生大量数据:候选解、工具调用、验证分数、成功轨迹和失败反思。Train-time scaling 的目标,是把这些一次性的计算沉淀进模型参数。
一个典型训练闭环是:
|
|
STaR 是一个代表性思路:模型生成推理过程,只用能够导向正确答案的推理继续训练;对于失败样本,则在已知答案的条件下重新生成解释。如此反复,让模型逐轮学会更有效的推理方式。
强化学习进一步直接优化环境奖励,但 reasoning RL 很容易出现训练不稳定、长度投机、奖励黑客或能力退化。DAPO 等工作表明,采样、裁剪、长度控制、动态过滤和批次构造这些看似细小的实现选择,会显著影响最终效果。这里真正可扩展的不是“多跑一些 RL”,而是一条可靠的数据—反馈—更新流水线。
7. Deep Research:从静态 RAG 到动态搜索
传统 RAG 通常在生成前检索一次,把若干文档塞进上下文。它有三个典型限制:
- 查询来自原始问题,尚未暴露推理中的真正知识缺口;
- 检索结果可能过长、相互冲突或与当前步骤无关;
- 后续推理发现新问题时,系统无法主动再次检索。
Agentic search 把检索变成推理过程中的动作。Search-o1 的核心思路是:模型在遇到知识缺口时暂停生成,提出查询,读取文档,再通过 Reason-in-Documents 提炼与当前推理有关的信息,最后继续回答。
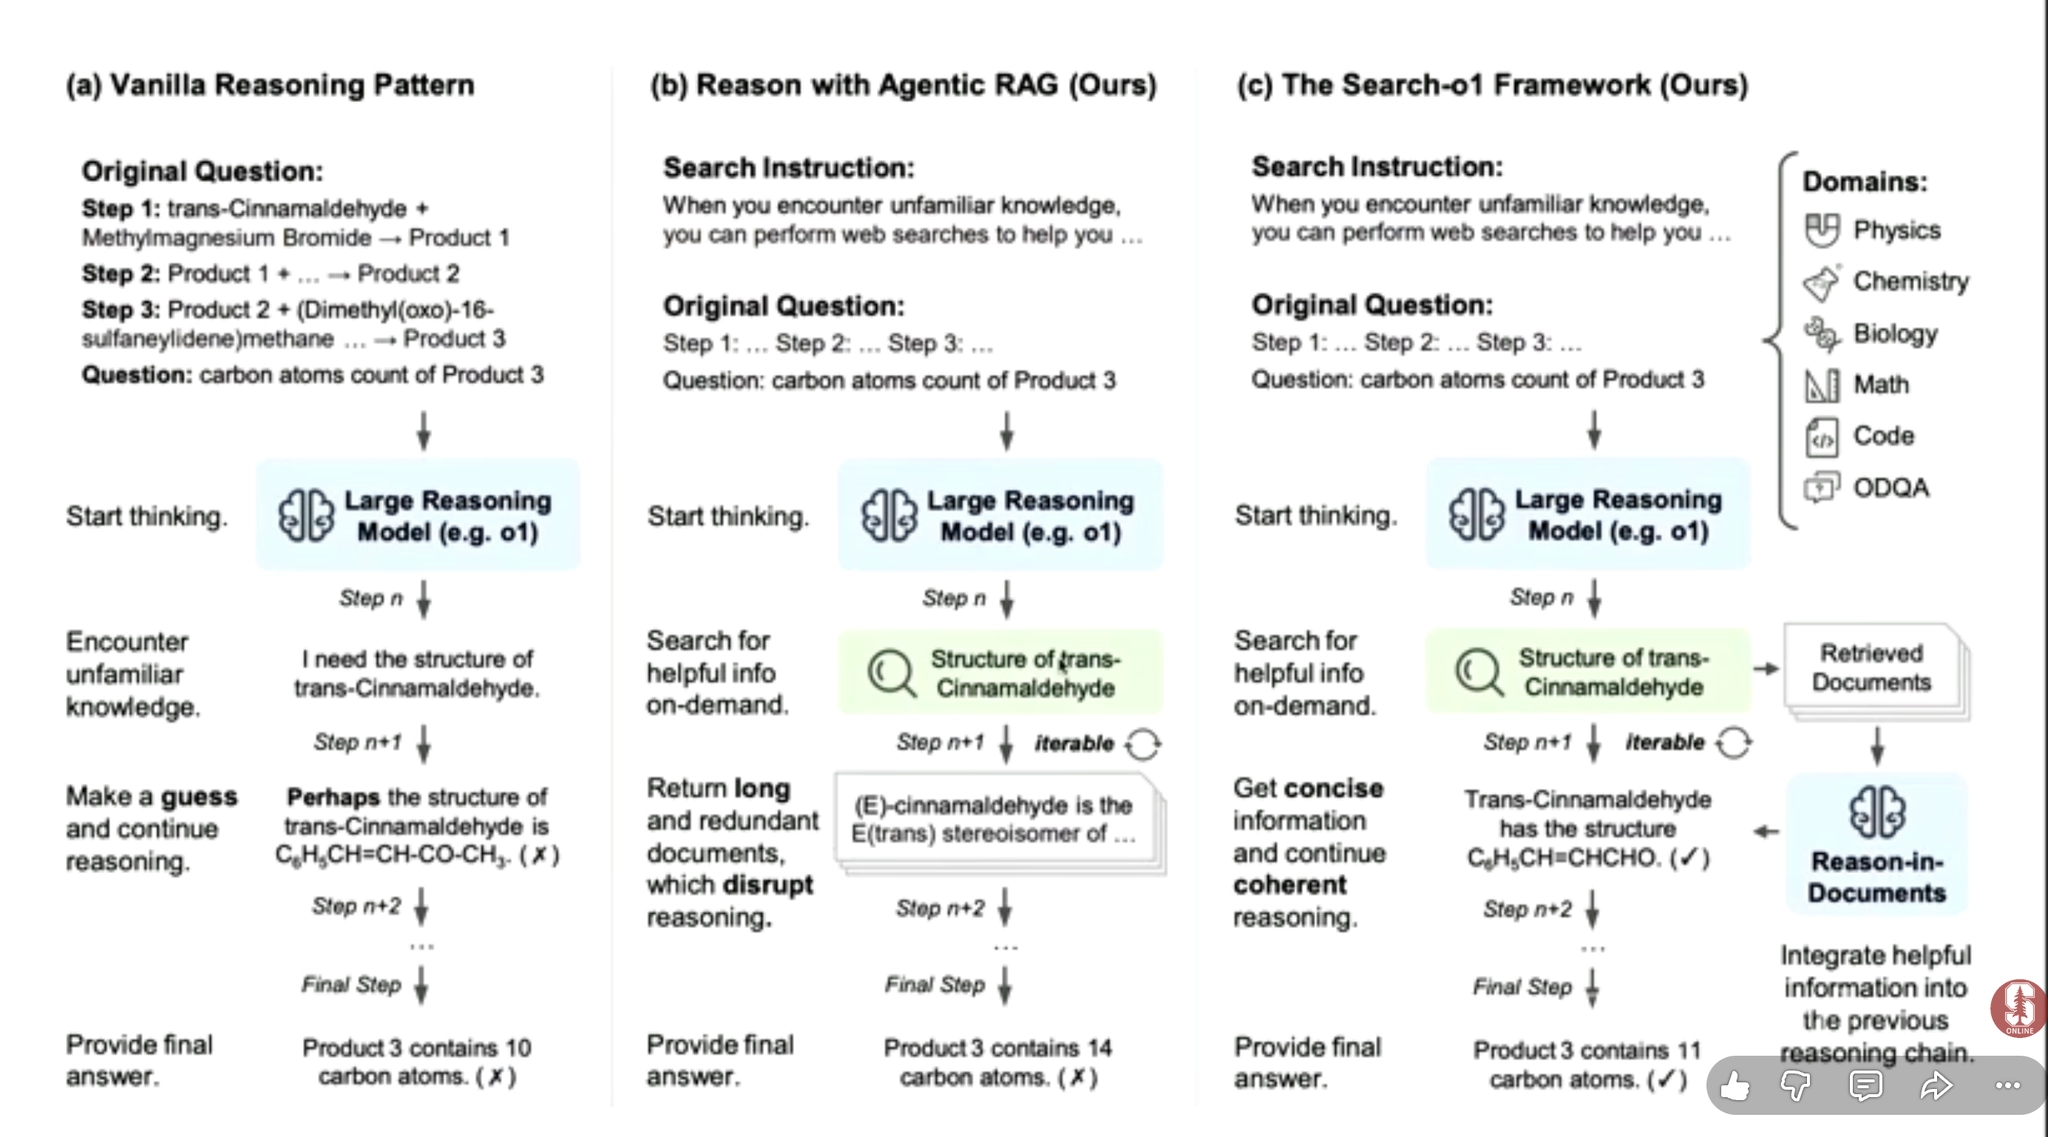
这使 Deep Research Agent 不再是“一次搜索 + 一次总结”,而是一个迭代过程:提出子问题、搜索证据、比较来源、发现冲突、补充检索、形成带依据的结论。与此同时,它也必须记录来源、控制检索成本,并避免网页内容中的指令劫持 Agent 的目标。
8. 如何评估长程 Agent?
单题准确率无法描述 Agent 是否能稳定完成真实工作。长程评测至少应该同时观察:
- 成功率:最终任务是否完成;
- 任务时间跨度:相当于人类多长时间的工作;
- 成本与延迟:使用了多少 token、工具调用和实际时间;
- 恢复能力:工具失败或计划走偏后能否回退;
- 验证器校准:高分是否真的意味着高成功率;
- 安全性:是否越权、泄露数据或执行不可逆操作。
如果一个任务包含 $n$ 个关键步骤,每一步独立成功率都为 $p$,整条链路成功率近似为 $p^n$。例如每一步都有 95% 的成功率,连续 20 步全部成功的概率也只有约 36%。虽然现实中的步骤并不独立,这个简化模型仍然说明:长程任务会放大微小的不可靠性。
Measuring AI Ability to Complete Long Tasks 提出了一个直观指标:模型能以 50% 成功率完成的任务,其人类专家通常需要多长时间。这个 time horizon 适合观察能力随时间的变化,但它依赖具体任务分布,不能被理解为模型在所有真实工作上的通用时长承诺。
9. 一个统一的工程架构
把前面的内容放在一起,一个可落地的 Self-Improving Agent 通常包含以下组件:
| 组件 | 职责 | 关键问题 |
|---|---|---|
| Generator / Policy | 生成答案或动作 | 候选是否足够多样? |
| Environment / Tools | 返回真实状态与执行反馈 | 反馈是否可信、可隔离? |
| Verifier / Reward | 判断结果与过程质量 | 会不会过拟合或被利用? |
| Search / Controller | 分配预算、扩展与剪枝 | 什么难度值得继续搜索? |
| Memory / Buffer | 保存轨迹、证据与经验 | 如何避免错误记忆累积? |
| Learner | 用反馈更新策略 | 改进能否跨任务泛化? |
| Evaluator | 在独立任务上度量变化 | 是否同时衡量质量、成本和安全? |
整体循环可以写成下面的伪代码:
|
|
这里最重要的一行不是 policy.update,而是反馈进入 buffer 之前的验证与过滤。错误反馈一旦被模型反复学习,就会从一次失败变成稳定行为。
10. 结论:反馈质量决定改进上限
Self-Improving AI Agents 的核心,不是让模型“自己想得更久”,而是建立一个可验证的闭环:
- 测试时计算提高候选覆盖率;
- 验证器和环境反馈负责识别好轨迹;
- 搜索与规划把预算投入更有希望的路径;
- 工具让模型获得外部证据和可执行反馈;
- 训练把成功经验沉淀为下一轮能力;
- 长程评测确认这种改进是否可靠、经济且安全。
它的能力上限最终受制于反馈质量。没有可靠验证器,更多采样只会产生更多无法选择的答案;没有独立评测,自我训练可能只是把偏差越放越大;没有安全边界,行动能力越强,错误的代价也越高。
真正值得追求的不是“能够无限自我改进”的口号,而是一个每轮变化都可测量、可追踪、可纠错的工程系统。
参考资料
- Stanford CS329A: Self-Improving AI Agents
- Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters
- Large Language Monkeys: Scaling Inference Compute with Repeated Sampling
- Let’s Verify Step by Step
- Shrinking the Generation-Verification Gap with Weak Verifiers
- ReAct: Synergizing Reasoning and Acting in Language Models
- WebGPT: Browser-assisted Question-answering with Human Feedback
- RLEF: Grounding Code LLMs in Execution Feedback with Reinforcement Learning
- Language Agent Tree Search Unifies Reasoning, Acting, and Planning in Language Models
- When is Tree Search Useful for LLM Planning?
- Self-Taught Reasoner: Bootstrapping Reasoning With Reasoning
- DAPO: An Open-Source LLM Reinforcement Learning System at Scale
- Search-o1: Agentic Search-Enhanced Large Reasoning Models
- Measuring AI Ability to Complete Long Tasks
文章作者 zhengxz
上次更新 2026-08-11