Anthropic Agent 演进(一):从 Workflow 到 Agent,为什么需要 Harness
文章目录
“Agent” 经常被当作一个宽泛标签:只要模型调用了工具、执行了多步任务,就被称为 Agent。Anthropic 的工程实践给出了一个更有用的区分:Workflow 的路径由代码预先定义;Agent 则由模型根据环境反馈动态决定下一步。
这是“Anthropic Agent 演进”系列的第一篇。我们先建立共同语言:从增强型 LLM、固定 Workflow,一直到真正的自主 Agent,并解释为什么模型外部还需要一层 Harness。
系列导航:(一)从 Workflow 到 Agent · (二)Context Reset 与 Structured Handoff · (三)Planner–Generator–Evaluator · (四)Managed Agent Runtime
1. 起点:Augmented LLM
最基础的 Agentic System 不是多 Agent,而是一个获得外部能力的 LLM:
- Retrieval:查询模型参数之外的信息;
- Tools:执行搜索、代码、API 或业务动作;
- Memory:把需要跨轮次保留的状态写到上下文之外。
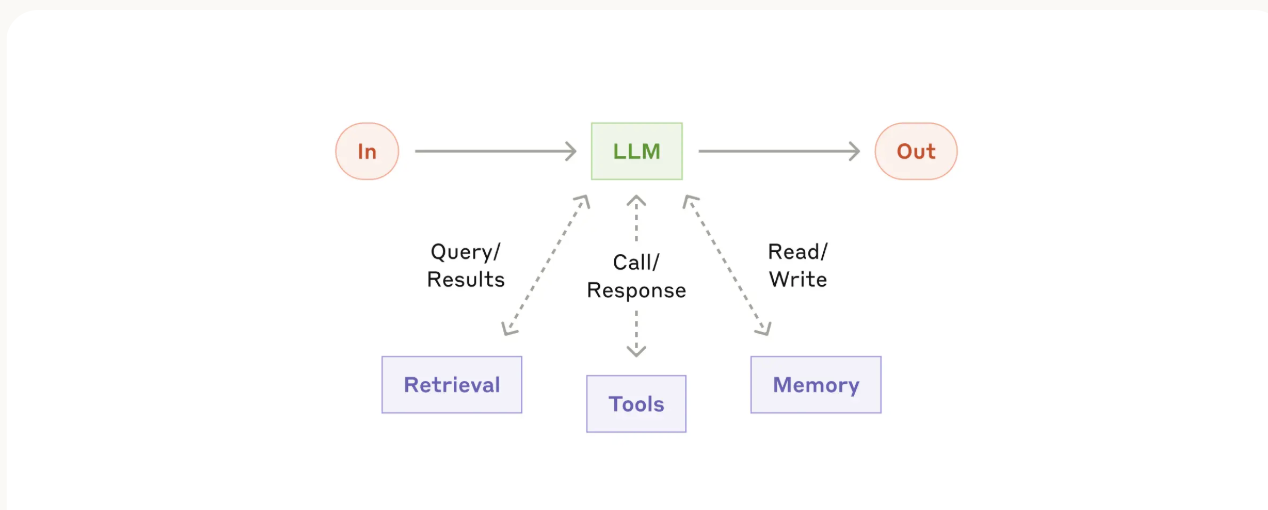
这一步的重点不只是“有工具”,而是工具接口是否适合模型使用。对人类友好的 API,不一定对模型友好。Agent-Computer Interface(ACI)需要明确的参数名、输入边界、示例、错误反馈和不容易误用的结构。
Anthropic 的建议很克制:先从最简单的调用开始,只有当评测证明复杂结构确实改善结果时,再增加 Agentic 组件。复杂度不是能力本身,它会同时引入延迟、成本和新的失败路径。
2. Workflow:把已知路径写进程序
当任务可以提前拆解时,Workflow 通常比自主 Agent 更稳定。
2.1 Prompt Chaining
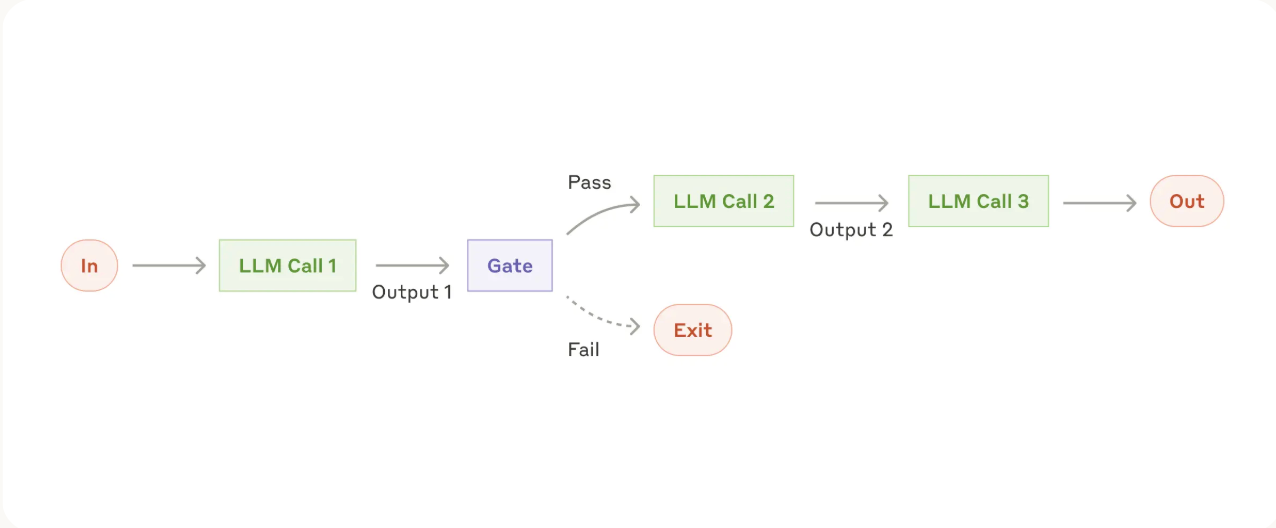
Prompt Chaining 把任务拆成顺序步骤,并允许在中间设置 Gate。它适合“先生成提纲、检查提纲,再写正文”这类依赖关系明确的任务。
2.2 Routing
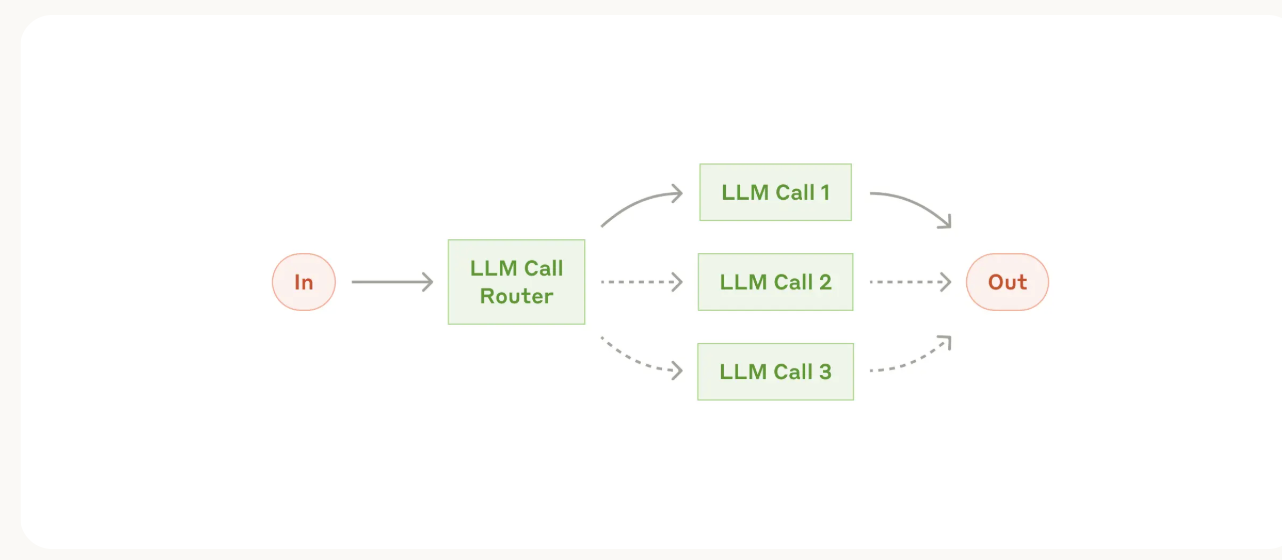
Routing 先识别输入类别,再交给对应的模型或提示词。它适合客服分流、难度分级和模型成本优化。
2.3 Parallelization
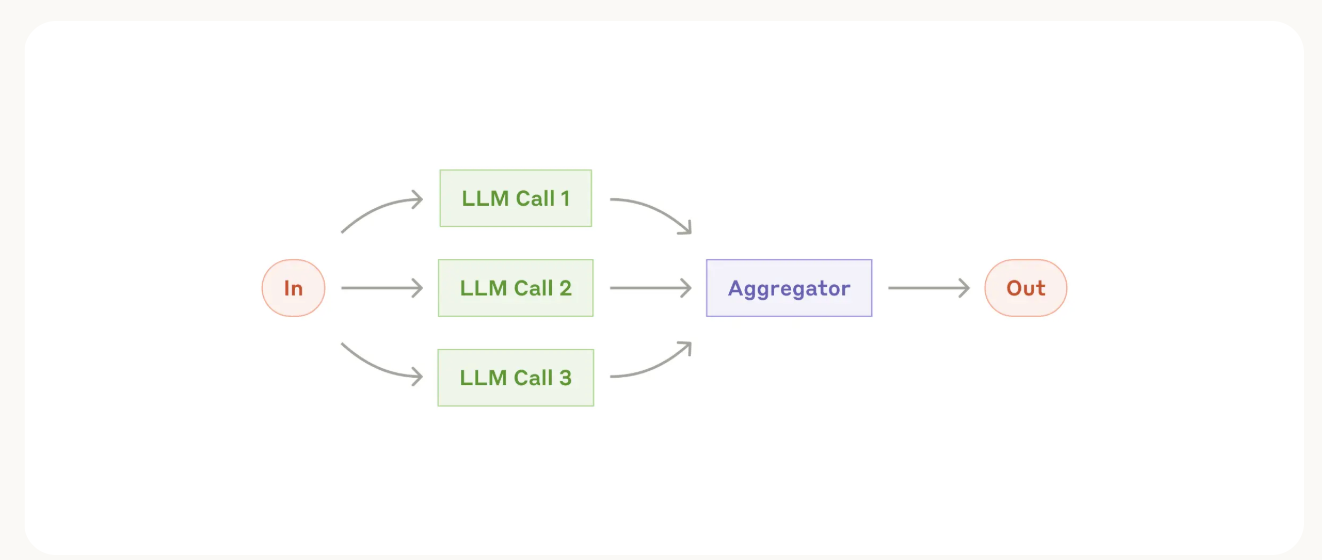
Parallelization 有两种常见形式:把独立子问题并行处理,或者让多个调用独立判断后投票。前者换取速度,后者换取置信度。
2.4 Orchestrator–Workers
当子任务无法提前确定时,Orchestrator 动态拆解任务、分配 Worker,再汇总结果。它看起来像并行 Workflow,但关键差别是:任务拓扑由模型在运行时决定。
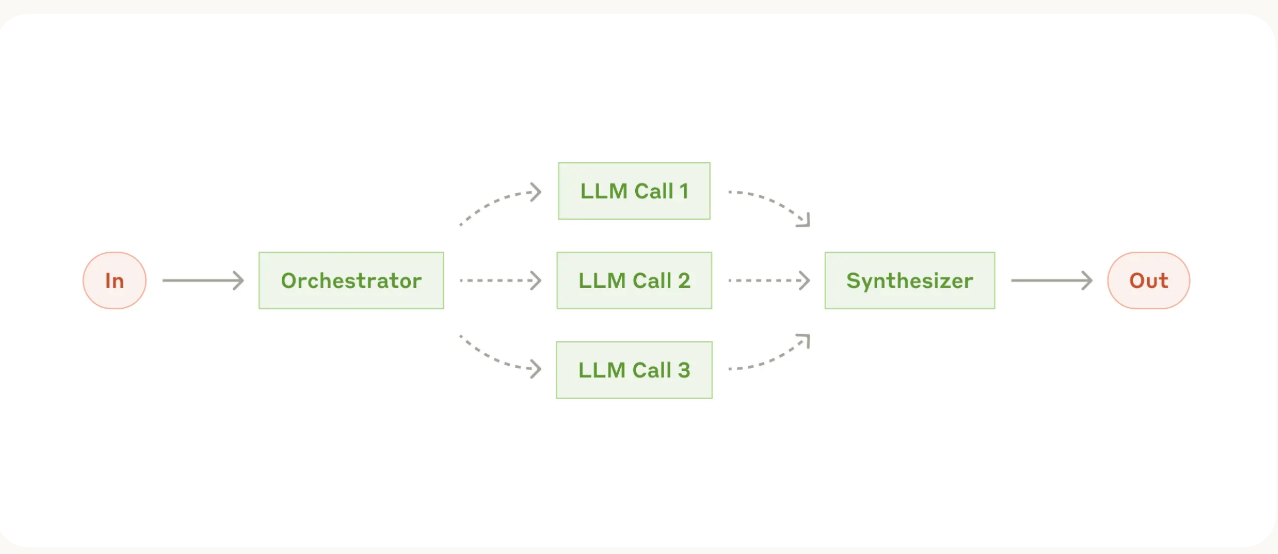
2.5 Evaluator–Optimizer
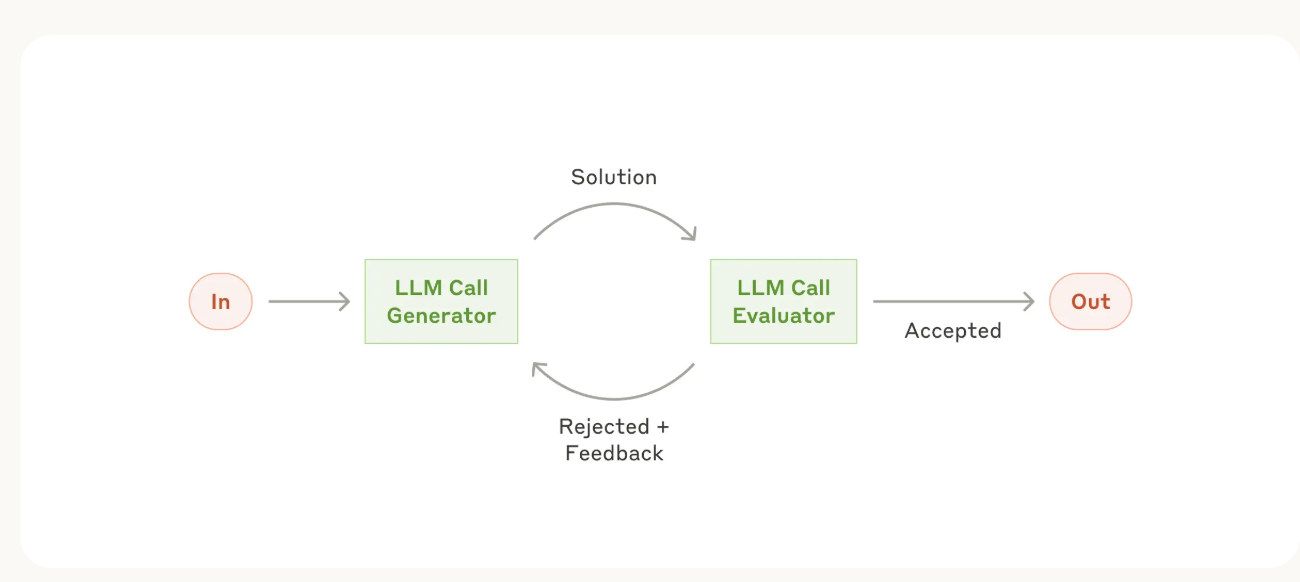
一个模型生成,另一个模型评价并反馈,直到结果被接受。这是后续 Planner–Generator–Evaluator Harness 的原型。
3. Agent:让模型决定过程
真正的 Agent 面对的是无法硬编码固定路径的问题。它持续执行下面的循环:
- 理解目标和当前状态;
- 选择工具或动作;
- 从环境获得 Ground Truth;
- 根据结果修正计划;
- 达成目标、遇到阻塞或触发停止条件时结束。
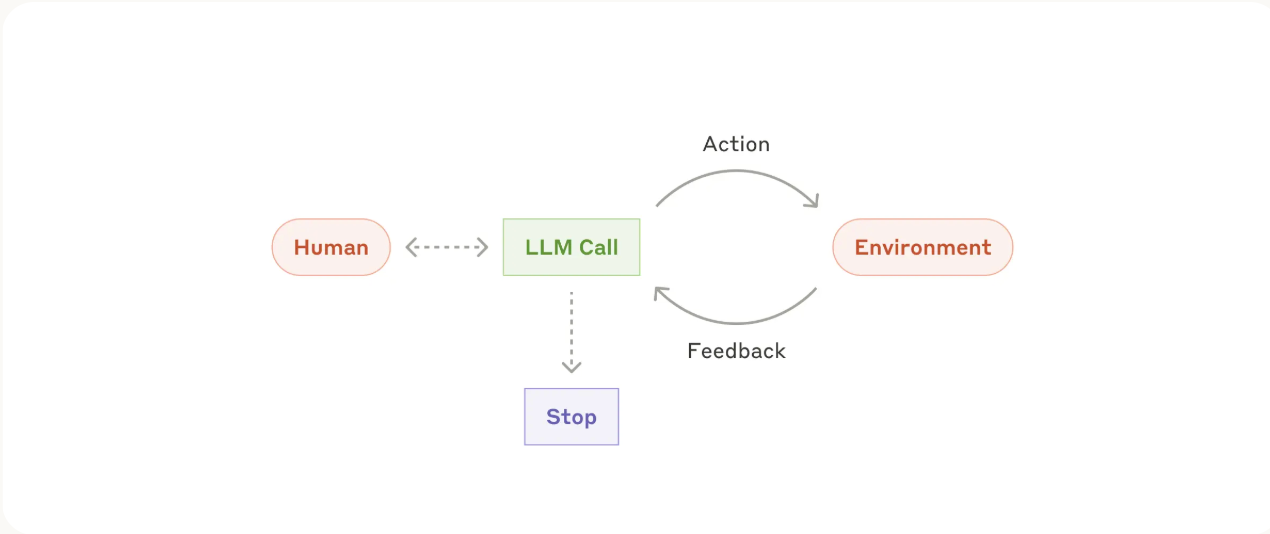
因此,自主性并不等于“无限运行”。可靠系统仍然需要预算、最大迭代次数、权限边界、人工检查点和明确的完成条件。
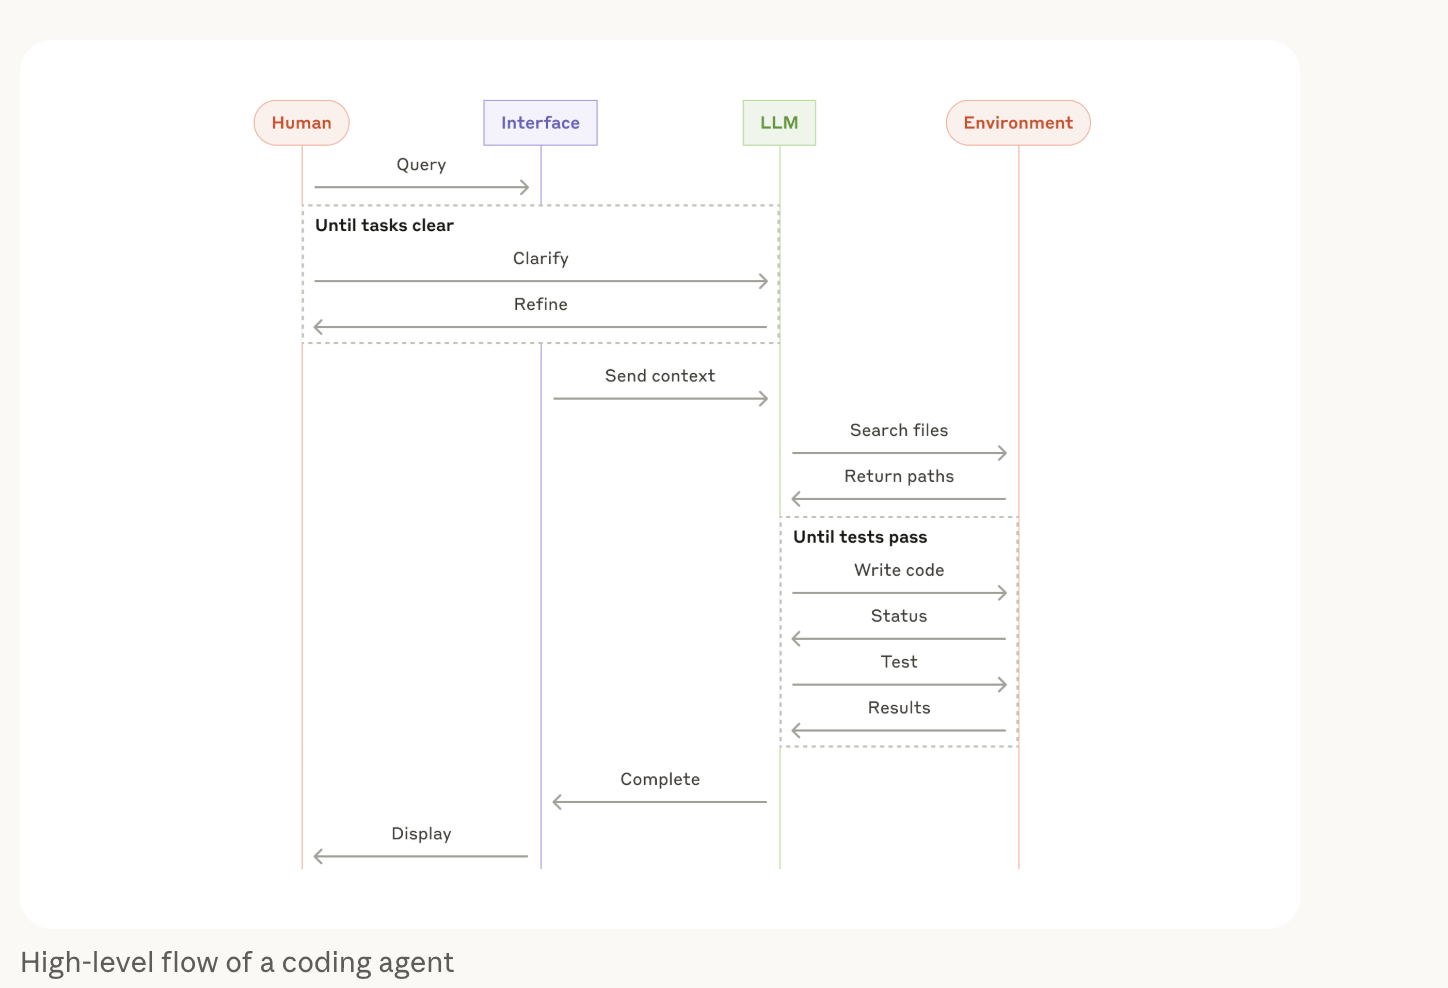
对于 Coding Agent,真正的验证器不是模型说“代码看起来没问题”,而是编译结果、测试输出、浏览器行为和代码仓库的实际状态。
4. 为什么模型外还需要 Harness?
裸 Agent 可以完成一次短任务,但长任务会暴露四类系统问题:
- 有限上下文:历史越来越长,相关信息被日志和失败尝试淹没;
- 状态连续性:新的 Context 或 Session 不知道上一轮发生了什么;
- 自我评价偏差:生成者倾向于高估自己的结果;
- 运行可靠性:工具、Sandbox、网络或 Harness 本身都可能失败。
Harness 是包裹模型的工程系统。它负责:
- 保存计划、任务状态、检查点和长期记忆;
- 为每一步选择必要上下文,而不是重放全部历史;
- 调度工具、Sandbox 和其他 Agent;
- 用外部测试和 Evaluator 验证结果;
- 在失败后重试、恢复或交给下一轮继续。
可以把两者理解为:模型提供推理能力,Harness 提供持续工作的制度。
5. 一条实用的复杂度阶梯
| 任务特征 | 首选结构 |
|---|---|
| 单次调用已能稳定完成 | Prompt + Retrieval |
| 步骤固定、可提前定义 | Prompt Chaining / Routing |
| 子任务独立或需要多视角 | Parallelization |
| 子任务随输入动态变化 | Orchestrator–Workers |
| 有清晰评价标准且可反复改进 | Evaluator–Optimizer |
| 路径开放、需持续读取环境反馈 | Agent + Harness |
最重要的原则不是“尽量 Agent 化”,而是:只有当更简单的系统无法达到目标,并且评测证明复杂度有收益时,才向下一层演进。
下一篇将进入长任务的第一个关键问题:Context Window 用完后,工作如何继续?
参考资料
文章作者 zhengxz
上次更新 2026-09-12