Anthropic Agent 演进(三):Planner–Generator–Evaluator 质量闭环
文章目录
第一代 Harness 让 Agent 能跨 Context 持续工作,但“持续”不等于“高质量”。生成者评价自己的作品时,往往会把“基本能运行”误判成“已经足够好”,主观设计任务尤其明显。
Anthropic 的下一步是把计划、生成和评价拆成三个职责,让外部 Evaluator 成为 Generator 必须面对的反馈来源。
系列导航:(一)从 Workflow 到 Agent · (二)Context Reset 与 Structured Handoff · (三)Planner–Generator–Evaluator · (四)Managed Agent Runtime
1. 两个互相连接的问题
Anthropic 的实验同时关注:
- 如何让 Claude 产出不落入模板化的高质量前端;
- 如何让 Agent 在几乎无人干预的情况下构建完整应用。
它们表面不同,底层却共享同一个问题:Generator 不能可靠地判断自己的成果。
即使结果有明确正确性,模型也会忽略边缘情况;面对审美、产品深度和易用性等主观维度时,它更容易给自己的作品过高评价。
解决思路不是要求 Generator “再批判一点”,而是把评价职责分离,并针对评价本身做校准。
2. 三 Agent 的职责边界
2.1 Planner
Planner 把 1–4 句话的需求扩展为完整产品规格:目标用户、范围、主要体验、功能切片和高层技术设计。它不应过早锁死具体实现。
2.2 Generator
Generator 根据 Spec 持续构建产品,以 Sprint 为单位完成多个相关功能,使用 Git 保存阶段状态,并根据 Evaluator 的反馈决定继续 Refine 还是彻底 Pivot。
2.3 Evaluator
Evaluator 不是静态代码审查器。它使用 Playwright 操作真实运行的应用,覆盖 UI、API 和数据库状态,再从产品深度、功能、视觉设计和代码质量等维度评分。
三个角色形成:
Planner 定义“要构建什么” → Generator 实现 → Evaluator 用真实行为判断 → Generator 修复 → 循环直到达标
3. 先把“好”变成可评价标准
“这个设计漂亮吗?”很难稳定回答;“它是否满足一组明确设计原则?”则可以逐项判断。
Anthropic 为前端实验定义了四类 Rubric:
- Design Quality:颜色、字体、布局和图像是否形成一致整体;
- Originality:是否有明确的自定义选择,而不是模板默认值和常见 AI 套路;
- Craft:层级、间距、色彩、对比度等执行质量;
- Functionality:用户能否理解界面并完成核心任务。
Rubric 仍不会自动可靠。Evaluator 需要用包含详细评分理由的 Few-shot 样例校准,减少迭代之间的评分漂移,并有意训练成更怀疑、更愿意寻找反例的 QA。
4. Generator–Evaluator 如何迭代?
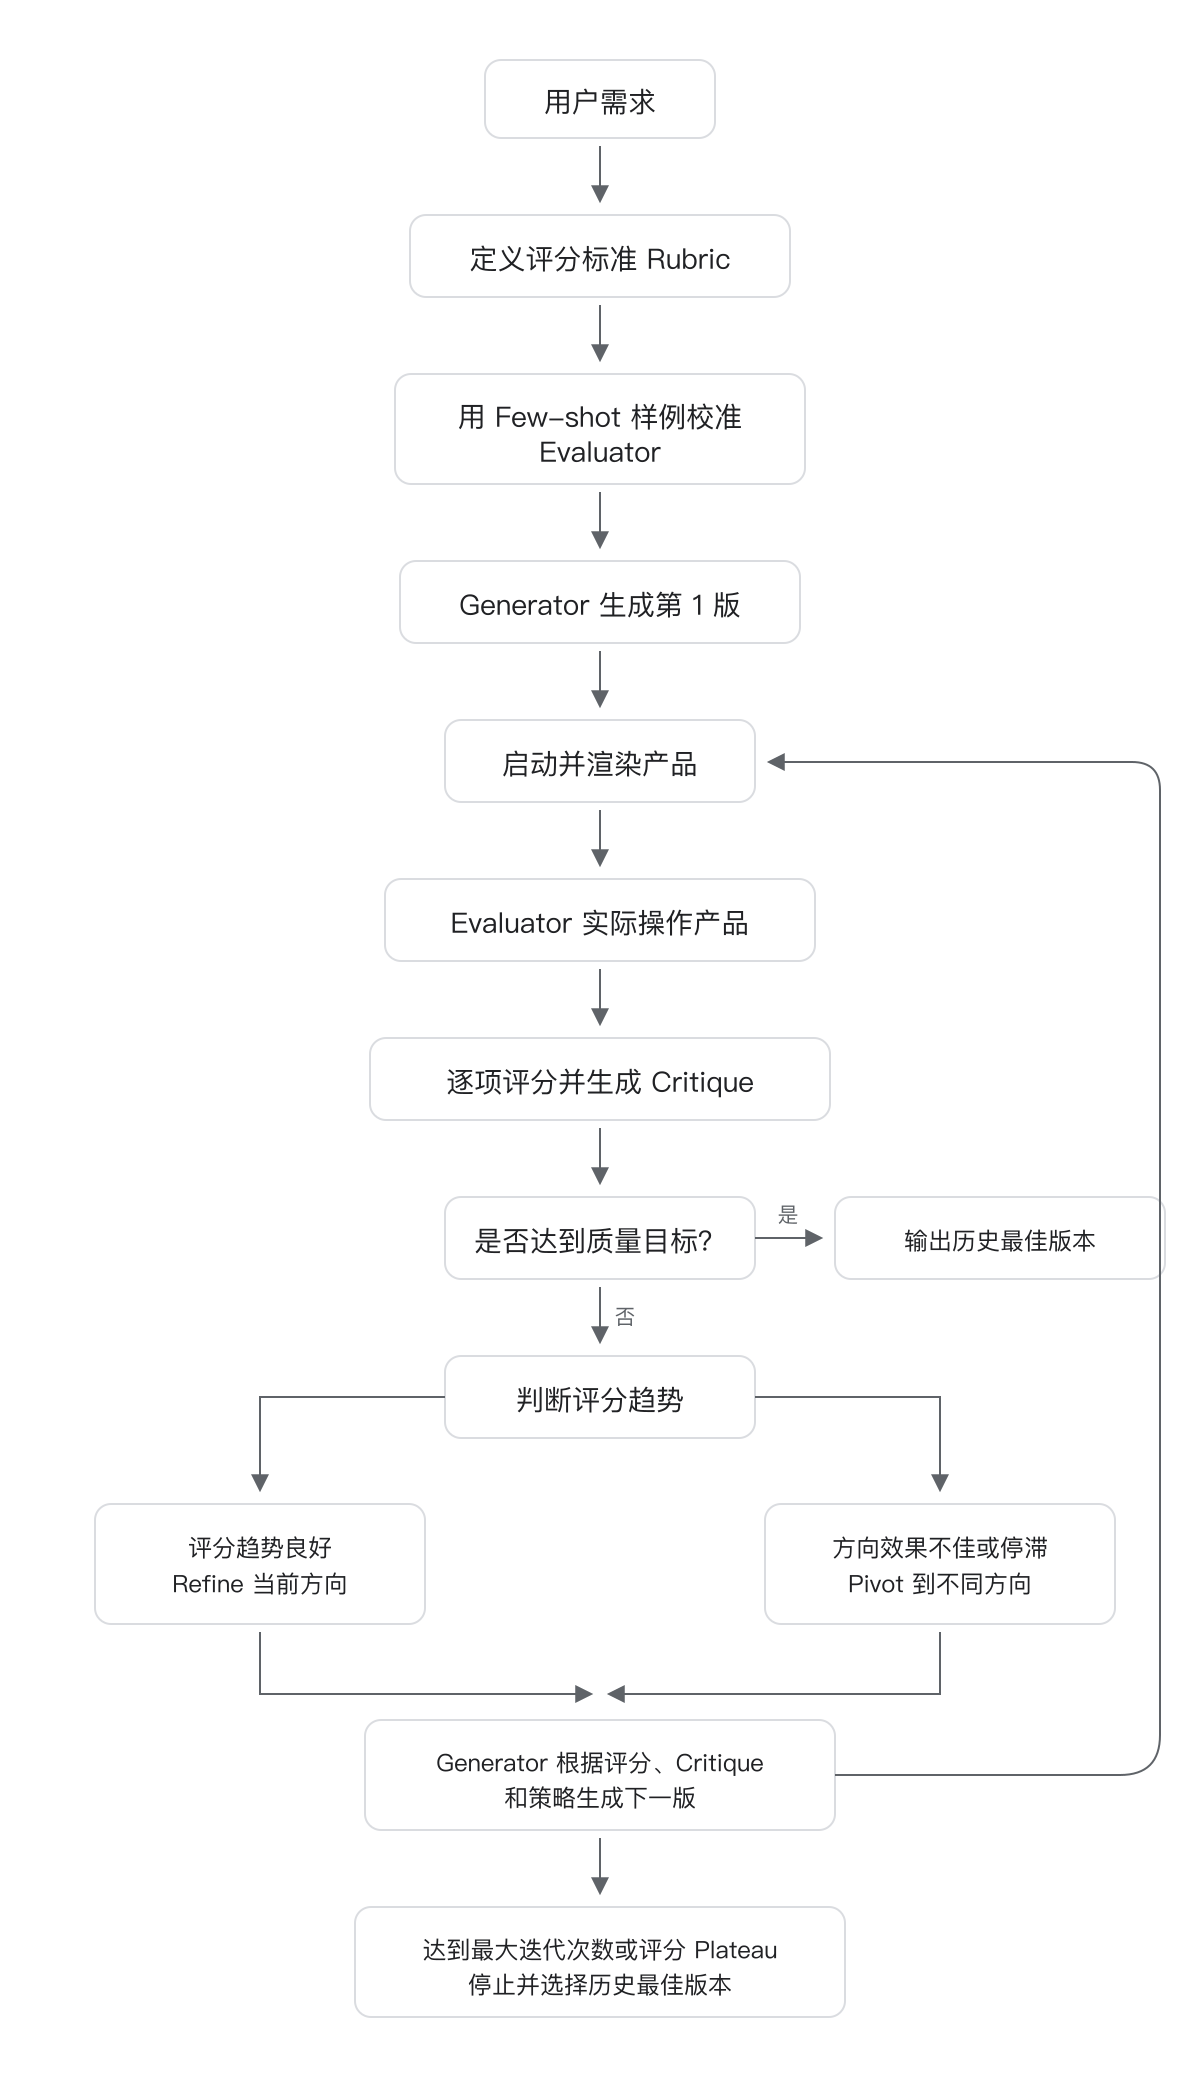
完整循环可以拆成:
- 定义评价维度、阈值与权重;
- 用 Few-shot 样例校准 Evaluator;
- Generator 生成第一个版本;
- 启动真实产品,让 Evaluator 实际操作;
- Evaluator 逐项评分并给出可执行 Critique;
- Generator 根据评分趋势选择 Refine 或 Pivot;
- 达到目标、评分进入 Plateau 或用完预算后,选择历史最佳版本。
关键不是“多跑几轮”,而是每轮都必须从环境获得新的 Ground Truth。如果 Evaluator 只读 Generator 的总结,这仍然是同一套偏差在内部循环。
5. Sprint Contract:在写代码前定义 Done
完整产品 Spec 通常过于高层,无法直接作为单个 Sprint 的验收标准。因此 Generator 和 Evaluator 会先协商 Sprint Contract:
- 这一轮具体实现哪些行为;
- 如何验证每个行为;
- 什么情况算失败;
- 哪些内容明确不在当前范围。
Contract 把用户故事和测试实现之间的空白显式化。任何维度低于硬阈值,Sprint 就失败,Generator 必须根据具体发现修复。
Agent 之间通过文件交换 Spec、Contract、评价和修复结果。这种结构化通信不仅跨 Agent,也天然支持跨 Session 恢复。
6. 为什么必须让 Evaluator 像用户一样操作?
静态截图只能发现视觉问题,代码审查也无法证明真实交互可用。Evaluator 需要:
- 点击实际控件和完整用户路径;
- 检查 API 返回和数据库状态;
- 对照 Contract 的每一条标准;
- 给出具体到行为、条件甚至代码位置的失败原因。
Anthropic 的案例显示,单 Agent 版本表面完整,但核心游戏模式不可用;完整 Harness 虽然仍有粗糙边缘,却能真正运行关键路径。高质量提升来自外部反馈闭环,而不是更长的自我思考。
7. 成本与收益:Harness 不是免费的
该实验中,Solo Harness 运行约 20 分钟、成本约 9 美元;完整 Harness 运行约 6 小时、成本约 200 美元,超过 20 倍。
因此三 Agent 结构不适合所有任务。它更适合:
- 输出价值高,失败代价大;
- 有明确 Rubric 或可构建可靠 Evaluator;
- 迭代反馈可以显著改进结果;
- 任务足够复杂,单 Agent 已被证明达不到质量目标。
8. Harness 也要随模型演进
Harness 的每个组件都编码了一个假设:“模型自己做不到这件事。”模型升级后,这些假设可能过期。例如某一代模型的 Context Anxiety 需要 Reset,新模型可能已经不再表现出这个问题。
正确做法是像做消融实验一样,一次移除一个组件,观察质量、成本和速度变化。Harness 的目标不是流程越多越好,而是以最小必要结构释放当前模型的能力,并把剩余弱点变成可验证反馈。
下一篇将从“如何让 Agent 做好工作”转向“如何让 Agent Runtime 可恢复、可扩展、可连接不同执行环境”。
参考资料
文章作者 zhengxz
上次更新 2026-09-12