Anthropic Agent 演进(二):Context Reset 与 Structured Handoff
文章目录
长任务的核心矛盾不是“模型能不能写代码”,而是:任务可能持续数小时或数天,但一次 Context Window 终究有限。把整个历史无限重放,会同时遇到容量和噪声问题。
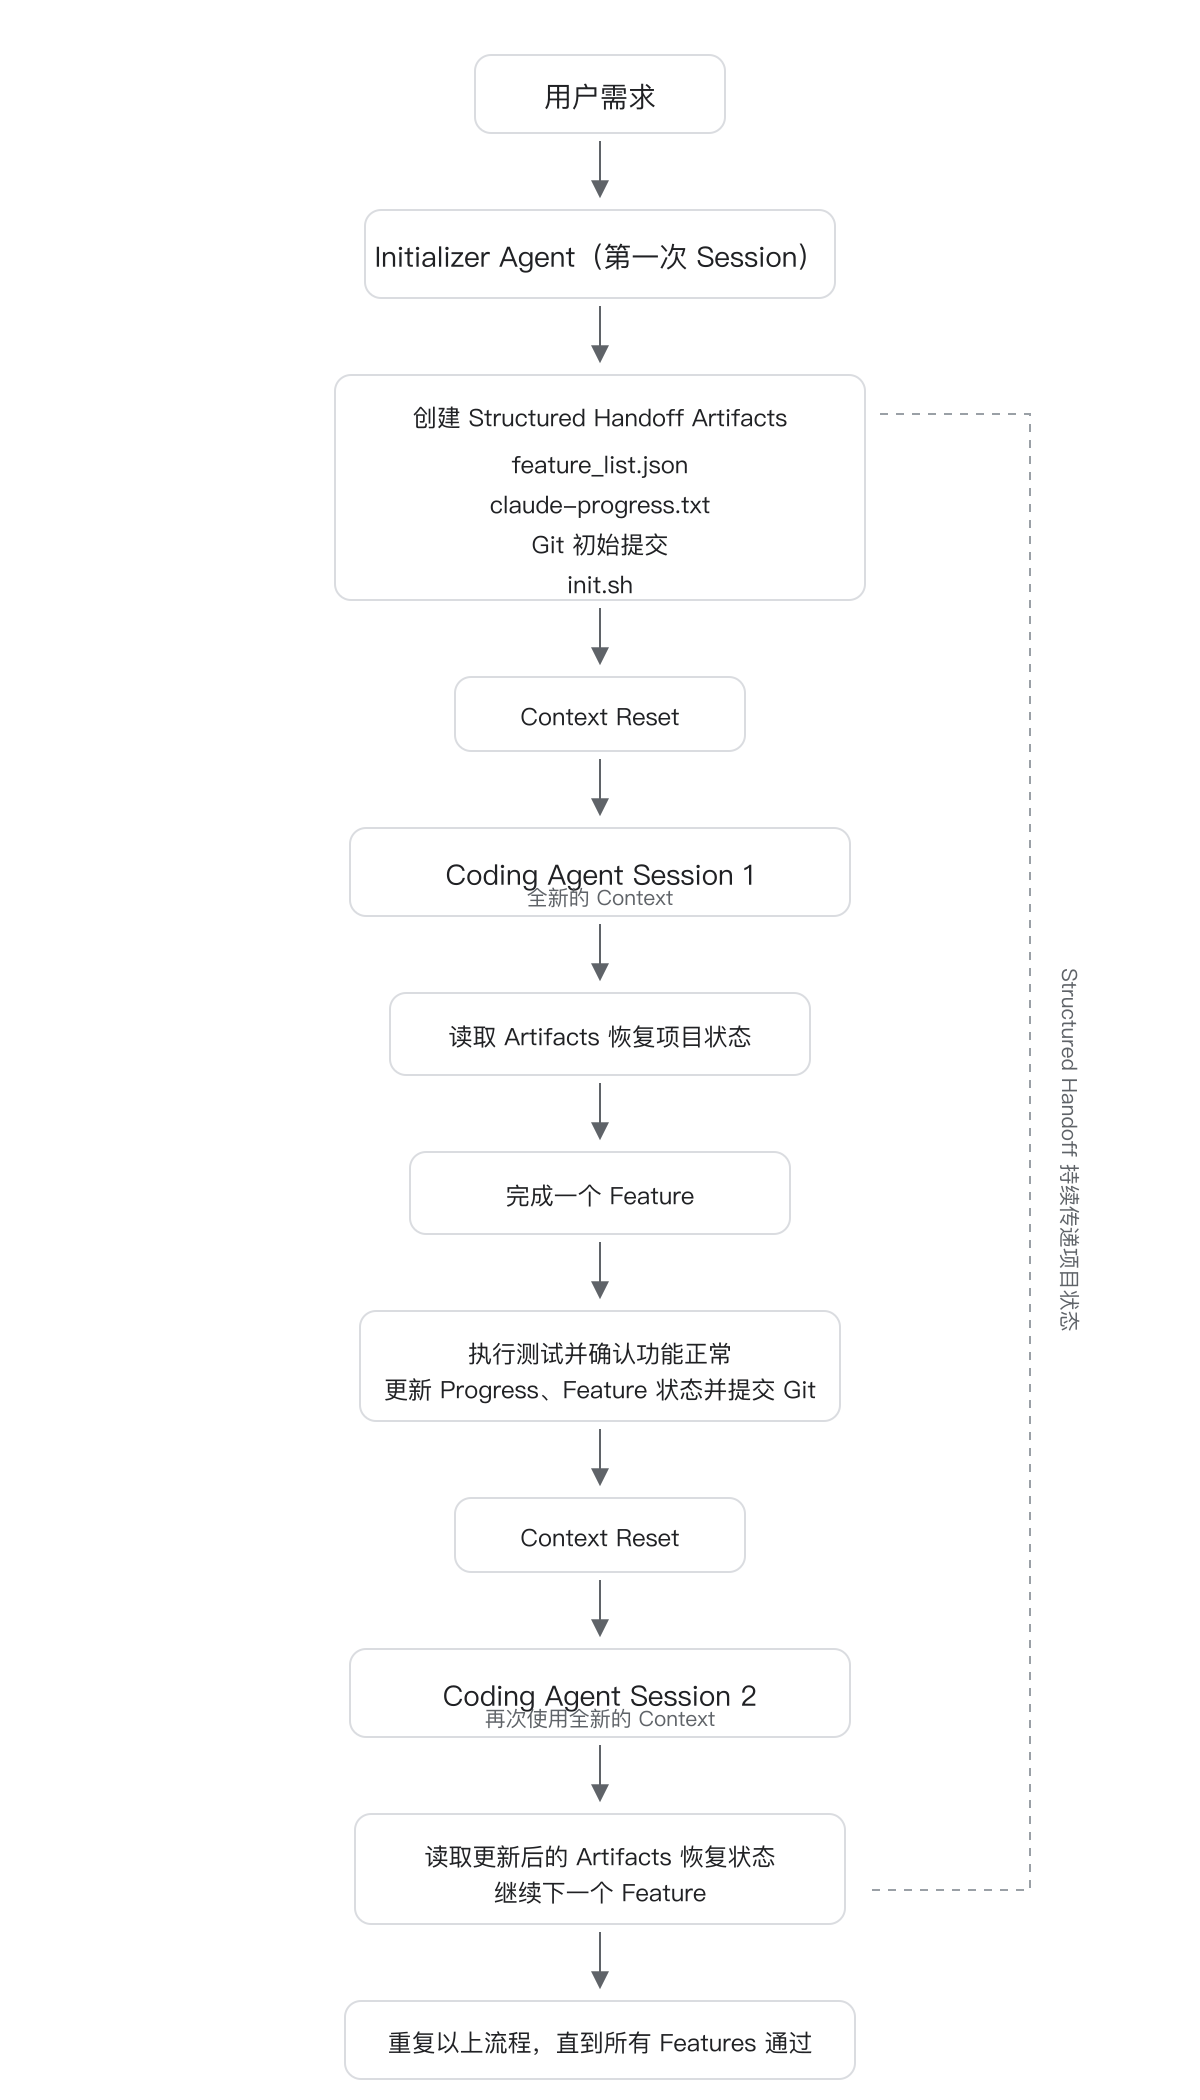
Anthropic 第一代 Long-Running Agent Harness 的答案是:重置对话上下文,但把项目状态写进结构化工件,让下一轮 Agent 可以恢复工作。
系列导航:(一)从 Workflow 到 Agent · (二)Context Reset 与 Structured Handoff · (三)Planner–Generator–Evaluator · (四)Managed Agent Runtime
1. 为什么 Compaction 还不够?
Context Compaction 会总结较早的对话,把压缩结果留在同一个 Agent 和 Session 中。它的优势是连续、便宜、编排简单,但它不能保证提供真正干净的起点:
- 摘要可能遗漏未来才显得重要的细节;
- 过期计划、错误假设和噪声可能被一同保留;
- 模型仍能感受到 Context 接近上限,并出现提前收尾的 “Context Anxiety”;
- 下一轮可能只看到“已经完成了很多”,于是过早宣布成功。
Context Reset 则清空 Context Window,用全新的 Agent 实例继续。代价是必须有足够完整的 Handoff,否则状态会丢失。
| 方法 | 优点 | 风险 |
|---|---|---|
| Context Compaction | 保持同一 Session 的连续性;编排简单;延迟和 Token 开销较低 | 摘要可能失真;旧假设与噪声继续存在;不是干净起点 |
| Context Reset | 清空噪声和过期假设;每一轮都能重新聚焦 | 依赖高质量 Handoff;增加编排、恢复和检查成本 |
这两者不是互斥关系。成熟系统可以在短周期内 Compaction,在阶段边界或上下文明显劣化时 Reset。
2. 两类 Agent:Initializer 与 Coding Agent
Anthropic 将工作拆成两个角色:
2.1 Initializer Agent
第一轮不急着实现功能,而是建立后续所有 Session 共享的工作环境:
feature_list.json:完整功能、验收步骤和通过状态;claude-progress.txt:本轮进展、测试结果、已知问题和下一步;- Git 初始提交:建立可追溯、可回退的基线;
init.sh:统一启动环境和基本检查方式。
其中 Feature List 很关键。它把“完成项目”从模糊感觉变成一组初始均为失败、需要逐项验证的外部事实。
2.2 Coding Agent
后续每一个新 Context 都执行相同协议:
- 读取目录、Git 历史、Progress 和 Feature List;
- 运行
init.sh并做基础端到端检查; - 只选择一个尚未通过的高优先级 Feature;
- 实现并通过真实环境验证;
- 只在证据充分时修改
passes状态; - 写 Progress、提交 Git,留下干净状态。
3. Structured Handoff 到底传递什么?
好的 Handoff 不是一段“我大概做了这些”的自然语言摘要,而是多层互相校验的状态:
- Spec / Feature List 回答“完整目标是什么”;
- Progress Log 回答“上一轮做了什么、哪里有风险”;
- Git History 回答“代码实际发生了什么变化”;
- Code + Tests 是当前系统状态的最终事实来源;
- Startup Script 回答“如何恢复一个可验证的运行环境”。
它们解决了两个不同问题:Context Reset 清理模型内部的短期工作区;Structured Handoff 保留模型外部的长期项目状态。
可以概括为:
Fresh Context + Durable Artifacts + Ground-Truth Tests = 可持续的长任务执行
4. 为什么强调“一次只完成一个 Feature”?
裸 Agent 容易试图一次性完成整个应用,结果在 Context 用完时留下半成品。下一轮既无法判断设计意图,也不清楚哪些部分可靠。
增量策略把每轮输出约束为一个可合并状态:
- 变更范围足够小,便于理解和回退;
- 每轮都必须恢复并检查现有系统;
- 完成条件对应可执行的验收步骤;
- Session 结束时没有与当前 Feature 无关的烂尾状态。
这与优秀人类工程团队的换班方式非常相似:不是共享每一次聊天,而是共享 Issue、提交、测试和可运行系统。
5. 测试是 Handoff 的一部分
模型的自我评价并不足够。Anthropic 发现,只运行单元测试或 curl 也可能错过真实用户路径。对 Web 应用,Agent 需要使用浏览器自动化像用户一样点击、输入、观察 UI 与后端状态。
因此,“测试通过”不能只是 Progress 文件里的文字。它应该包含可重放步骤和环境反馈。下一轮 Agent 首先执行冒烟测试;如果前一轮留下损坏状态,应先修复基线,再开始新 Feature。
6. 这一代 Harness 的边界
Initializer + Coding Agent 解决了跨 Context 连续性,却没有完全解决质量判断:
- Generator 仍可能对自己的成果过度乐观;
- 主观质量很难靠单一通过/失败字段表达;
- 更复杂应用需要在产品规划、实现和 QA 之间形成制衡;
- Harness 组件本身也可能随模型变强而成为负担。
这直接引出了下一阶段:把“做工作”和“判断工作”分离,形成 Planner–Generator–Evaluator 三 Agent 系统。
参考资料
文章作者 zhengxz
上次更新 2026-09-12